Points clés
- Définition et rôle d’un cluster de basculement : un cluster de basculement est un groupe de serveurs (nœuds) qui transfèrent automatiquement les charges de travail en cas de défaillance, afin d’assurer une haute disponibilité, des temps d’arrêt minimes et la continuité d’activité.
- Composants essentiels et prérequis : il faut plusieurs nœuds, un logiciel de gestion de cluster, un réseau fiable et, souvent, un stockage partagé pour détecter les défaillances et déclencher un basculement fluide.
- Fonctionnement du clustering de basculement (étapes) : le cluster surveille en continu l’état des nœuds → détecte une défaillance → transfère automatiquement les services et les applications vers un nœud sain → rétablit les opérations avec un minimum d’interruption de service.
- Types et configurations de clusters de basculement : les modèles courants comprennent les clusters actif-actif et actif-passif, ainsi que les architectures à disque partagé et sans partage, qui influent chacune sur les performances, le coût et la complexité.
- Bonnes pratiques pour des clusters de basculement fiables : éliminez les points de défaillance uniques, testez régulièrement le basculement, maintenez des configurations cohérentes entre les nœuds et surveillez les performances pour garantir résilience, évolutivité et disponibilité.
La continuité des opérations et la résilience des systèmes sont des enjeux majeurs de l’informatique d’entreprise moderne. La technologie de cluster de basculement joue un rôle de premier plan pour atteindre ces objectifs. Cet article explore en profondeur le fonctionnement des clusters de basculement et leurs applications. Que vous soyez un professionnel de l’informatique aguerri ou simplement curieux, poursuivez votre lecture. Nous verrons comment comprendre les subtilités des clusters de basculement, comment ils fonctionnent et dans quels scénarios ils se révèlent indispensables.
Qu’est-ce qu’un cluster de basculement ?
Un cluster de basculement est une forme spécialisée d’infrastructure à haute disponibilité. Il est conçu pour garantir un fonctionnement ininterrompu en cas de défaillance matérielle ou logicielle. Il s’agit essentiellement d’un groupe d’ordinateurs interconnectés qui fonctionnent ensemble comme un système unique. L’objectif est d’assurer la redondance et une disponibilité continue. La fonction première d’un cluster de basculement consiste à détecter les défaillances d’un composant du système. Il transfère ensuite automatiquement la charge de travail vers un composant opérationnel, sans perturbation perceptible pour les utilisateurs.
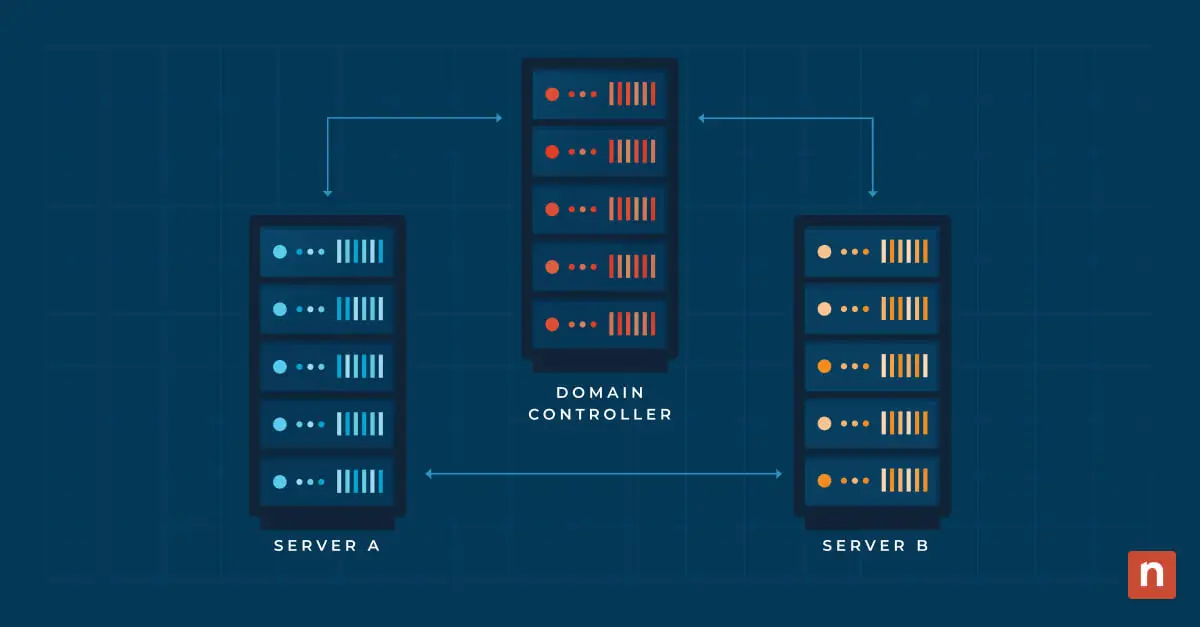
Les composants clés d’un cluster de basculement comprennent généralement plusieurs serveurs (ou nœuds), des ressources de stockage partagées et un logiciel de gestion de cluster. Ce logiciel surveille l’état et le bon fonctionnement des nœuds. Lorsqu’une défaillance est détectée (une panne matérielle, par exemple), le logiciel de gestion de cluster orchestre le processus de basculement. Il s’agit de transférer la charge de travail et les responsabilités du nœud défaillant vers un nœud sain. L’objectif final est de garantir que les services ou les applications restent accessibles et opérationnels.
Renforcez votre résilience opérationnelle avec les outils de reprise d’activité après incident de NinjaOne.
Clusters de basculement à haute disponibilité et à disponibilité continue
La haute disponibilité désigne la capacité d’un système ou d’un service à réduire les temps d’arrêt en se rétablissant rapidement après une défaillance. Les clusters de basculement à haute disponibilité disposent généralement des moyens de détecter une panne, de lancer automatiquement un processus de basculement et de reprendre les opérations sur un nœud de secours. L’objectif est de réduire les temps d’arrêt au minimum. Les services sont ainsi rapidement rétablis, sans perturbation notable.
Les clusters de basculement à disponibilité continue s’en distinguent légèrement : ils privilégient le maintien d’un service ininterrompu, avec un temps d’arrêt minimal, voire nul. La disponibilité continue implique une transition fluide des services d’un nœud défaillant vers un nœud sain, afin que les utilisateurs finaux ne perçoivent aucune interruption. Cela nécessite généralement une réplication synchrone des données vers le nœud de secours.
Sûreté et sécurité grâce à la redondance
La redondance est un concept fondamental du clustering de basculement. Elle consiste à intégrer des composants ou des systèmes en double au sein d’un cluster afin d’assurer fiabilité et tolérance aux pannes. L’objectif premier de la redondance est d’éliminer les points de défaillance uniques. Il s’agit des vulnérabilités d’un système susceptibles d’entraîner des interruptions de service ou des pertes de données en cas de compromission. Dans le cadre du clustering de basculement, la redondance joue un rôle déterminant. Elle contribue à maintenir les opérations en continu, même lorsqu’un ou plusieurs composants tombent en panne.
Dans un cluster de basculement, la redondance se met en place de différentes manières :
- Redondance des nœuds : les clusters de basculement se composent de plusieurs nœuds, c’est-à-dire de serveurs individuels qui fonctionnent ensemble comme un système unifié. Si un nœud tombe en panne pour des raisons matérielles ou logicielles, les nœuds restants du cluster prennent le relais afin d’éviter toute interruption. Ainsi, même si un serveur devient indisponible, les services ou les applications peuvent basculer sans heurt vers un autre nœud opérationnel.
- Redondance du stockage partagé : les clusters utilisent souvent des ressources de stockage partagées, comme des réseaux de stockage (SAN), pour maintenir la cohérence des données sur l’ensemble des nœuds. La redondance du stockage partagé s’obtient grâce à des technologies comme le RAID (Redundant Array of Independent Disks), qui protège contre les défaillances de disques. Ainsi, même en cas de panne d’un périphérique de stockage, les données restent accessibles grâce aux mécanismes de stockage redondants. Pour approfondir ces notions, notamment les conseils pratiques sur l’implémentation des SAN et leurs avantages, consultez Qu’est-ce qu’un réseau de stockage (SAN) ? Avantages et implémentation.
- Redondance réseau : la communication entre les nœuds du cluster est essentielle à leur coordination et à la synchronisation des données. La redondance réseau consiste à disposer de plusieurs chemins et interfaces réseau, afin que le cluster puisse continuer à communiquer par des voies alternatives si une connexion réseau tombe. Cela évite l’isolement des nœuds et garantit une disponibilité continue.
- Redondance de l’alimentation et du matériel : les alimentations redondantes, les systèmes de refroidissement et d’autres composants matériels contribuent à la fiabilité globale du cluster de basculement. Ces mesures protègent contre les pannes provoquées par des coupures de courant ou des dysfonctionnements matériels.
Pourquoi le clustering de basculement est essentiel
Le clustering de basculement occupe une place centrale dans l’infrastructure informatique moderne, car il répond à des enjeux critiques comme la haute disponibilité et l’accès permanent aux données et aux services. Voici un examen détaillé de son importance :
- Disponibilité :
la haute disponibilité est indispensable aux systèmes et aux applications qui doivent rester accessibles en permanence. En répartissant les charges de travail sur plusieurs nœuds, les clusters de basculement font en sorte que, si un nœud tombe en panne, les services ou les applications basculent sans heurt vers un nœud sain. Qu’il s’agisse d’applications critiques, de bases de données ou de services web, le maintien de la disponibilité est essentiel pour répondre aux attentes des utilisateurs et garantir la continuité des opérations.
- Réduction des temps d’arrêt :
les temps d’arrêt peuvent avoir de lourdes conséquences pour les entreprises : perte de productivité, de chiffre d’affaires et de satisfaction client. Le clustering de basculement limite les temps d’arrêt en réagissant rapidement aux défaillances matérielles ou logicielles. Le mécanisme de basculement automatique transfère la charge de travail vers un autre nœud opérationnel de manière transparente. C’est particulièrement utile en cas de panne d’un nœud, car cela réduit le délai nécessaire pour retrouver la disponibilité du serveur.
- Continuité des données et des services :
la continuité des données et des services est au cœur du clustering de basculement. Grâce à des composants redondants et à des mécanismes de basculement, les clusters permettent aux entreprises de conserver un accès ininterrompu aux données et aux services critiques. La redondance du stockage partagé assure la cohérence des données entre les nœuds. Parallèlement, les mécanismes de basculement des applications et des services garantissent aux utilisateurs la poursuite de leurs tâches sans interruption. C’est déterminant face à des défaillances imprévues. Ce niveau de continuité est vital pour préserver l’intégrité des données, respecter les accords de niveau de service (SLA) et bâtir une infrastructure informatique résiliente, capable de résister à des situations très diverses.
- Optimisation des ressources :
les clusters de basculement permettent une utilisation efficace des ressources en répartissant dynamiquement les charges de travail selon l’état et la capacité de chaque nœud. Cette optimisation aide les entreprises à rentabiliser au mieux leurs investissements matériels. Elle garantit par la même occasion que les ressources de calcul sont attribuées là où les besoins sont les plus importants à un moment donné.
- Maintenance simplifiée :
les clusters de basculement facilitent les opérations de maintenance sans perturber les services. Ils permettent une approche non intrusive de la maintenance des systèmes. Les administrateurs peuvent en effet mettre des nœuds hors ligne pour la maintenance ou les mises à niveau, pendant que les nœuds restants continuent de gérer la charge de travail.
Types de clusters de basculement
Les clusters de basculement se répartissent en deux grandes catégories : les clusters « shared-nothing » (sans partage) et les clusters « shared-disk » (à disque partagé). Chacune répond à des besoins spécifiques. Le choix entre ces types de clusters dépend de facteurs comme le cas d’utilisation précis. Il peut aussi dépendre des besoins d’évolutivité et de la volonté de l’entreprise de gérer une certaine complexité.
- Clusters de basculement sans partage (shared-nothing)
Dans un cluster de basculement sans partage, chaque nœud fonctionne de manière indépendante, avec son propre jeu de ressources dédiées, y compris un stockage local. Ces clusters utilisent un réseau commun pour communiquer. Ils peuvent recourir à un stockage partagé pour la configuration ou comme disque témoin, mais les données applicatives ne sont pas partagées directement. Les clusters sans partage sont souvent privilégiés pour leur simplicité et le risque réduit de point de défaillance unique. Ils peuvent toutefois présenter des limites en matière d’évolutivité et entraîner une hausse du trafic réseau lors des basculements.
- Clusters de basculement à disque partagé (shared-disk)
Ces clusters de basculement reposent sur un système de stockage centralisé, où tous les nœuds partagent l’accès aux données applicatives. Il s’agit généralement d’un réseau de stockage (SAN) ou d’un stockage en réseau NAS. Un cluster à disque partagé offre une bonne évolutivité, puisque l’ajout de nœuds permet d’augmenter la puissance de traitement et la capacité de stockage. En revanche, les clusters de basculement à disque partagé sont souvent plus complexes à mettre en place. Ils sont également plus délicats à gérer en raison des configurations de stockage partagé. Des problèmes de contention des ressources peuvent aussi survenir lorsque plusieurs nœuds accèdent au même stockage.
Clusters de basculement Hyper-V, Windows Server et VMware
Certains types de clusters de basculement sont liés à des plateformes de virtualisation répandues. C’est le cas d’Hyper-V (Microsoft) et de VMware. Examinons les différents types de clusters de basculement dans le contexte de ces plateformes :
Types de clusters de basculement Hyper-V
Clusters d’hôtes Hyper-V
Dans un cluster Hyper-V, plusieurs serveurs physiques (les nœuds évoqués plus haut) sont regroupés en cluster pour héberger et gérer collectivement des machines virtuelles (MV). Si un nœud tombe en panne, les MV basculent automatiquement vers un autre nœud sain du cluster, garantissant ainsi une disponibilité continue.
Avantages :
- Haute disponibilité pour les charges de travail virtualisées.
- Migration automatique des MV en cas de panne d’un nœud.
Points à prendre en compte :
- Nécessite un stockage partagé pour les fichiers des MV.
Hyper-V Replica
Hyper-V Replica assure la réplication asynchrone des MV d’un hôte Hyper-V vers un autre. En cas de défaillance de l’hôte principal, la MV répliquée peut être activée sur l’hôte secondaire, ce qui réduit les temps d’arrêt.
Avantages :
- Séparation géographique pour la reprise d’activité après incident.
- Réplication asynchrone offrant plus de souplesse.
Points à prendre en compte :
- Implique une certaine perte de données en cas de basculement.
Types de clusters de basculement Windows Server (WSFC)
Clusters de basculement de serveurs de fichiers
Les clusters de basculement Windows Server (WSFC) peuvent être configurés pour assurer la haute disponibilité des services de serveur de fichiers. Plusieurs nœuds coopèrent pour garantir l’accès aux fichiers et dossiers partagés, avec basculement automatique en cas de défaillance d’un nœud ou d’un service.
Avantages :
- Accès continu aux fichiers pour les utilisateurs.
- Récupération automatique après une panne de nœud.
Points à prendre en compte :
- Nécessite un stockage partagé pour les fichiers partagés.
Clusters de basculement SQL Server
Des clusters de basculement peuvent être mis en place pour assurer la haute disponibilité des bases de données SQL Server. Plusieurs nœuds hébergent des instances SQL Server. En cas de défaillance, les services basculent sans heurt vers un autre nœud.
Avantages :
- Disponibilité continue des bases de données SQL Server.
- Basculement automatique pour réduire les temps d’arrêt au minimum.
Points à prendre en compte :
- Nécessite un stockage partagé pour les fichiers de base de données.
Types de clusters de basculement VMware
vSphere High Availability (HA)
VMware vSphere HA assure la haute disponibilité des machines virtuelles au sein d’un cluster vSphere. Si un hôte tombe en panne, les MV redémarrent automatiquement sur d’autres hôtes du cluster.
Avantages :
- Redémarrage automatique des MV pour un fonctionnement continu.
- Aucun stockage partagé requis.
Points à prendre en compte :
- Peut entraîner un bref temps d’arrêt des MV pendant le basculement.
Fault Tolerance (FT)
VMware FT assure une disponibilité continue en maintenant une copie secondaire d’une MV sur un autre hôte. Si l’hôte principal tombe en panne, la MV secondaire prend le relais sans interruption.
Avantages :
Aucun temps d’arrêt en cas de défaillance d’un hôte.
Protection continue au niveau de la MV.
Points à prendre en compte :
Nécessite un stockage partagé et une prise en charge matérielle spécifique.
Variantes de clusters hybrides
Ces configurations combinent des éléments issus de différentes technologies ou plateformes pour atteindre des objectifs précis. Les clusters de basculement SQL Server et les clusters Red Hat Linux en sont deux exemples. Voyons-les de plus près :
Clusters de basculement SQL Server
Un cluster de basculement SQL Server est une configuration hybride qui associe SQL Server de Microsoft au clustering de basculement Windows Server. Dans cette architecture, plusieurs nœuds hébergent des instances SQL Server, et le cluster de basculement garantit une haute disponibilité des bases de données.
Avantages :
- Disponibilité continue des bases de données SQL Server.
- Basculement automatique en cas de défaillance d’un nœud ou d’un service.
- Exploite le clustering de basculement Windows Server pour plus de fiabilité.
Points à prendre en compte :
- Nécessite un stockage partagé pour les fichiers de base de données.
- Les fonctionnalités de clustering de basculement Windows Server font partie intégrante des capacités de basculement de SQL Server.
Clusters Red Hat Linux
Les clusters Red Hat Linux reposent souvent sur des technologies comme Pacemaker et Corosync. Celles-ci permettent de créer des configurations à haute disponibilité pour les applications et les services sur des systèmes Linux. Ces clusters peuvent être hybrides. C’est le cas lorsqu’ils s’intègrent à des solutions de stockage de différents fournisseurs, à des technologies de virtualisation ou à des services cloud.
Avantages :
- Haute disponibilité pour les applications et services sous Linux.
- Souplesse d’intégration avec diverses technologies de stockage et de virtualisation.
- Adaptés aux déploiements sur site ou dans le cloud.
Points à prendre en compte :
- Exige de comprendre et de configurer les technologies de clustering Linux.
- Les aspects hybrides peuvent soulever des questions de compatibilité avec des solutions tierces.
- Ces variantes de clusters hybrides illustrent la souplesse et la capacité d’adaptation des technologies de clustering aux besoins spécifiques de chaque plateforme.
Le fonctionnement des clusters de basculement
Les clusters de basculement reposent sur un ensemble de serveurs interconnectés, appelés nœuds. Ceux-ci collaborent pour assurer la haute disponibilité et le fonctionnement continu des services ou des applications. L’objectif principal est de détecter les défaillances matérielles ou logicielles et d’y répondre. Et, au final, de réduire les temps d’arrêt et de maintenir la continuité de service. Le mécanisme s’articule autour des étapes clés suivantes :
- Formation du cluster
Plusieurs nœuds sont reliés à un réseau commun pour former un cluster. Le cluster peut utiliser un stockage partagé ou d’autres ressources partagées, selon son type, comme indiqué dans la section précédente.
- Surveillance de l’état de santé
Le logiciel de gestion de cluster surveille en permanence l’état et le bon fonctionnement de chaque nœud du cluster. Cette surveillance porte notamment sur les pannes matérielles, la connectivité réseau et la disponibilité des services critiques.
- Communication par battements de cœur (heartbeat)
Les nœuds communiquent entre eux via un procédé appelé communication heartbeat.Les heartbeats sont des signaux échangés entre les nœuds à intervalles réguliers pour confirmer le bon état et la disponibilité de chacun. Si un nœud cesse d’envoyer des heartbeats ou est considéré comme défaillant, le logiciel de gestion de cluster identifie un problème potentiel sur ce nœud.
- Propriété des ressources et politiques de basculement
Chaque nœud du cluster est capable d’héberger et de gérer les services ou les applications. Les politiques de basculement et les règles de propriété des ressources déterminent quel nœud est responsable de tel service à un instant donné. Ces règles garantissent qu’un autre nœud sain peut reprendre la charge de travail en cas de défaillance d’un nœud.
- Basculement automatique
Le logiciel de gestion de cluster déclenche un processus de basculement automatique dès qu’une défaillance survient. Le basculement consiste à transférer les services ou les applications du nœud défaillant vers un nœud sain du cluster. Ce processus est généralement transparent pour les utilisateurs et limite les perturbations au minimum.
- Stockage partagé (facultatif)
Dans certains clusters de basculement, un stockage partagé sert à conserver les données ou les configurations applicatives. Le stockage partagé permet un accès cohérent aux données entre les nœuds et facilite un basculement fluide.
- Intervention manuelle (facultative)
Les administrateurs peuvent avoir à intervenir manuellement dans certains cas, en particulier lors d’opérations de maintenance planifiées ou face à des problèmes spécifiques. Ces interventions manuelles garantissent que le processus de basculement respecte les exigences et les politiques de l’entreprise.
- Rétablissement et redondance
Après le basculement, le cluster continue de fonctionner avec les nœuds sains restants. Une fois le nœud défaillant remis en service ou remplacé, le cluster peut rééquilibrer ses ressources. Il peut aussi revenir à sa configuration d’origine.
En suivant ces étapes, les clusters de basculement offrent une solution robuste pour maintenir une haute disponibilité et limiter les temps d’arrêt dans les environnements informatiques critiques.
Applications du clustering de basculement
Les clusters de basculement trouvent des applications dans de nombreux secteurs et apportent des solutions solides pour assurer la continuité d’activité, la reprise d’activité après incident, l’évolutivité et la répartition de charge. Ces exemples concrets illustrent leur polyvalence :
Finance : continuité d’activité et reprise après incident (BCDR)
Les banques et les établissements financiers déploient des clusters de basculement pour garantir la disponibilité permanente de leurs services critiques. Cela comprend la banque en ligne et le traitement des transactions. En cas de panne d’un serveur, les mécanismes de basculement assurent un service ininterrompu et évitent les perturbations financières pour les clients.
Plateformes d’e-commerce : un temps de fonctionnement maximal
Les commerçants en ligne s’appuient sur des clusters de basculement pour que leurs sites d’e-commerce restent opérationnels. Et ce, en particulier pendant les pics de trafic ou en cas de panne serveur. Cette disponibilité continue est déterminante pour préserver la satisfaction client et le chiffre d’affaires.
Fournisseurs cloud : évolutivité et répartition de charge
Les fournisseurs cloud utilisent des clusters de basculement pour faire évoluer leurs services de façon dynamique. À mesure que la demande augmente, de nouveaux nœuds peuvent être ajoutés au cluster pour traiter la charge de travail efficacement. Les mécanismes de répartition de charge assurent une utilisation optimale des ressources et offrent aux clients des services cloud fiables et évolutifs.
Réseaux de diffusion de contenu (CDN) : rapidité et efficacité
Les CDN emploient des clusters de basculement pour garantir une diffusion rapide et fiable des contenus. Des nœuds répartis dans le monde entier traitent les requêtes des utilisateurs. Le processus de basculement redirige le trafic sans heurt vers des nœuds sains, ce qui évite les interruptions de service et optimise la diffusion des contenus.
Réseaux de télécommunications : une connectivité fiable
Les opérateurs télécoms déploient des clusters de basculement dans leurs réseaux pour gérer les services voix et données. En cas de congestion du réseau, le basculement réachemine les services de communication vers d’autres nœuds et maintient la connectivité des utilisateurs.
Industrie : planification de la reprise d’activité après incident
Les sites industriels utilisent des clusters de basculement pour assurer la continuité des systèmes de production et de chaîne d’approvisionnement. En cas de panne serveur, le basculement garantit que les processus de fabrication et le traitement des commandes ne sont pas affectés, ce qui limite les perturbations.
Administrations et services publics : continuité du service public
Les administrations déploient des clusters de basculement pour des services publics essentiels, comme le traitement des impôts ou les systèmes d’intervention d’urgence. La capacité de basculement garantit la poursuite des fonctions publiques essentielles, même lors d’événements imprévus ou de catastrophes.
Vous souhaitez améliorer la disponibilité de vos systèmes ? Regardez qu’est-ce qu’un cluster de basculement ? Fonctionnement et applications.
Réduisez les temps d’arrêt coûteux et assurez la continuité de votre activité avec NinjaOne.
L’impact du clustering de basculement
Comme vous avez pu le constater, le clustering de basculement est déterminant pour garantir la continuité des opérations. En particulier celles des systèmes informatiques critiques, et ce dans des secteurs très variés. Cette technologie robuste, illustrée par des applications concrètes, est indispensable à la continuité d’activité, à la reprise d’activité après incident, à l’évolutivité et à la répartition de charge.
L’intérêt du clustering de basculement en informatique tient à sa capacité à maintenir une haute disponibilité. Il optimise également l’utilisation des ressources et contribue largement à la résilience et à l’efficacité des entreprises dans un paysage technologique en constante évolution.
Si vous souhaitez bâtir une infrastructure informatique robuste, nous vous invitons à approfondir le sujet du clustering de basculement.