Les protocoles classiques de documentation des bugs passent souvent à côté des bugs dits « edge case », ceux qui ne surviennent que dans des conditions très particulières. Dans le pire des cas, ces perturbateurs créent des failles de sécurité et provoquent des pertes de données. D’où l’intérêt d’un cadre capable de détecter, consigner et reproduire ces cas limites tout en précisant leur nature, leur cause et leur impact.
Cet article explique comment constituer un journal d’incidents complet pour les cas limites et présente les bonnes pratiques de suivi des bugs.
Vous préférez un format visuel ? Regardez notre vidéo « Comment consigner et réutiliser les problèmes clients « edge case » sans perdre le contexte » pour en savoir plus.
Les éléments essentiels de la documentation des bugs edge case
Voici comment bâtir un cadre durable de documentation des bugs edge case, sans perdre le contexte :
Étape 1 : utiliser un modèle « edge case » standardisé
Commencez par créer un modèle comprenant les sections suivantes :
| Section | Description | Exemple |
| Titre | Décrivez brièvement le bug edge case. | « Le volume se coupe lorsque l’utilisateur ouvre VLC. » |
| Niveau de menace | Hiérarchisez les correctifs selon leur gravité. | Moyen : affecte l’UX (expérience utilisateur) mais pas la stabilité du système. |
| Informations sur le client et l’environnement | Indiquez le nom du client, le système d’exploitation de l’appareil et les configurations spécifiques. | Client XY : Windows 11 Pro (22H2), Lenovo ThinkPad X1, pilote audio Realtek v6.0.9235.1. |
| Étapes de reproduction | Séquence numérotée décrivant précisément chaque étape. |
|
| Résultat attendu et résultat obtenu | Notez les comportements inattendus. | Attendu : VLC lit le média sans modifier le volume du système. Obtenu : le volume du système se coupe automatiquement. |
| Solution de contournement ou correctif | Consignez les correctifs temporaires ou définitifs du bug edge case. |
|
| Bugs associés | Établissez des renvois entre les journaux d’incidents pour une meilleure visibilité. | Comportement similaire dans « Spotify coupe le volume du système au lancement » (incident n° 12345). |
| Auteur et date de soumission | Favorisez la responsabilisation et la transparence pour les futures QBR. | Soumis par : John D. Date : 1er septembre 2025 |
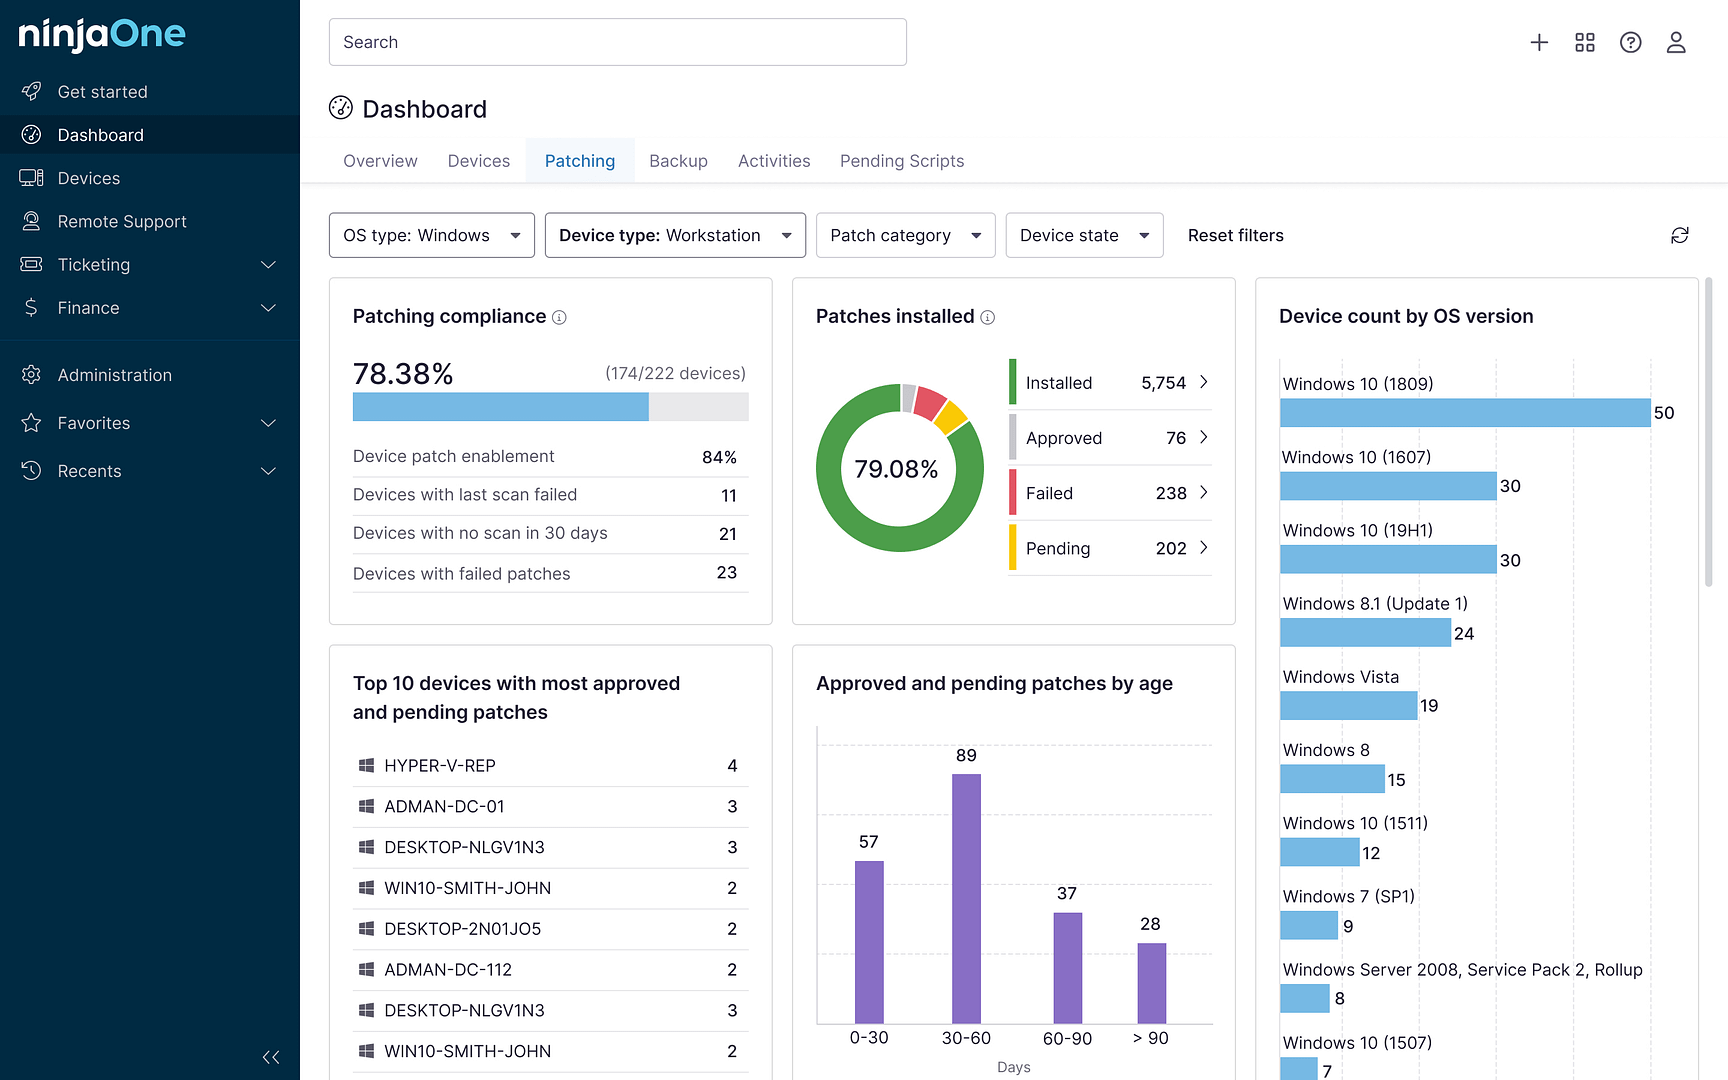
Les outils RMM modernes comme NinjaOne proposent des modèles de documents personnalisés pour les applications, les services et les terminaux, que vous pouvez adapter aux besoins de vos clients.
Étape 2 : joindre des preuves dès que possible
Dans la mesure du possible, joignez à votre documentation des captures d’écran du bug, des journaux d’erreurs et des enregistrements d’écran. Ajouter des visuels et commenter les scripts apporte du contexte et facilite le travail des développeurs et du support informatique lors des futurs dépannages.
Ce processus peut être automatisé à l’aide de scripts personnalisés pour réduire les tâches manuelles. Associé à des plateformes de gestion évolutives, il permet un contrôle centralisé à l’échelle de toute l’entreprise.
Étape 3 : utiliser des scripts de diagnostic légers
Des commandes efficaces comme powercfg ou perfmon permettent d’isoler les problèmes système et d’analyser leurs causes et leurs conséquences. Des bibliothèques de scripts dotées de méthodes de déploiement flexibles accélèrent considérablement ce travail.
🥷 | Fluidifiez vos processus avec des scripts indépendants de toute politique pour automatiser les tâches les plus ardues de la documentation des bugs. Découvrez la bibliothèque d’automatisation de NinjaOne ici.
Étape 4 : centraliser dans une base de connaissance interrogeable et balisée
Regroupez toutes vos ressources de documentation des bugs dans une Base de connaissance unique afin de fluidifier le débogage et de réduire la charge de travail. De plus, utilisez des étiquettes personnalisées et des dossiers par client, tout en conservant l’historique des révisions.
Ces services sont généralement proposés en bloc dans les plateformes cloud-native d’UEM (gestion unifiée des terminaux).
Étape 5 : définir une fréquence de revue
Les PME doivent être informées des menaces liées aux cas limites, en particulier de leur fréquence, de leur gravité et du temps moyen de résolution. Accorder une attention réelle à ces bugs négligés montre votre engagement en faveur d’opérations sans accroc et renforce la confiance de vos clients.
Pour réaliser un « état des lieux » proactif et pédagogique, procédez ainsi :
- Sélectionnez au hasard trois entrées edge case pertinentes.
- Essayez de reproduire les bugs identifiés.
- Marquez le cas limite comme obsolète si le logiciel ou l’environnement a déjà reçu un correctif.
Étape 6 : instaurer une culture grâce à des exemples concrets
Une documentation rigoureuse et un savoir partagé comptent parmi les marques de fabrique des équipes informatiques performantes. Pour encourager la réussite collective au sein de votre équipe, illustrez les bonnes pratiques avec des cas réels, valorisez le suivi des bugs et célébrez vos victoires.
⚠️ Points de vigilance
| Risques | Conséquences possibles | Mesures correctives |
| Absence de captures d’écran ou de journaux sur les cas limites | Les développeurs manquent de contexte, ce qui allonge le délai moyen de résolution (TTR) | Automatisez la collecte et le stockage des preuves à l’aide de scripts personnalisés et d’outils de surveillance des terminaux. |
| La documentation des bugs est éparpillée sur plusieurs plateformes. | Ressources fragmentées, réponse informatique retardée | Stockez la documentation dans une plateforme de gestion tout-en-un (par exemple NinjaOne, SharePoint). |
| Les scripts ne sont pas testés avant le déploiement. | Instabilité du système et fausses alertes | Testez les scripts dans des environnements restreints avant tout déploiement à grande échelle. |
| Aucun contrôle de version | Modifications obsolètes ou non autorisées | Créez des pistes d’audit et configurez les autorisations. |
| Les étapes de reproduction d’un cas limite ne sont pas validées. | Des bugs edge case sont marqués comme résolus à tort | Garantissez la reproductibilité avec des étapes numérotées et consignez les tentatives antérieures ainsi que leurs résultats. |
| Niveaux de menace imprécis | Une mauvaise hiérarchisation fait passer des bugs prioritaires entre les mailles du filet. | Formez les équipes informatiques aux niveaux de gravité, affinez les processus et utilisez des menus déroulants pour simplifier la saisie. |
Bonnes pratiques pour documenter les cas limites
Intégrez ces éléments pour rendre votre processus de documentation des bugs plus réutilisable :
- Modèle edge case : standardisez les modèles pour gagner en clarté et en cohérence, et imposez les champs obligatoires.
- Preuves et scripts : intégrez des éléments visuels pour apporter du contexte et limiter les suppositions.
- Base de connaissance centralisée et interrogeable : accélérez l’accès à la Base de connaissance grâce à un tableau de bord centralisé.
- Processus de revue : supprimez les entrées obsolètes et rappelez les règles de documentation lors des réunions trimestrielles.
- Cas réels rencontrés par les techniciens : ajoutez des situations vécues pour faciliter les renvois et améliorer l’onboarding.
- Étiquetage du niveau de menace : évaluez l’impact client et optimisez l’affectation des ressources.
- Attribution des soumissions : renforcez la responsabilisation et suivez la fiabilité des journaux d’incidents dans le temps.
L’apport de NinjaOne à la documentation des bugs
NinjaOne simplifie la documentation des bugs et la collecte de preuves :
- en joignant automatiquement captures d’écran, journaux et autres éléments aux tickets pour un reporting simplifié ;
- en réunissant l’étiquetage personnalisé, le suivi des révisions et la cartographie des parties prenantes dans une plateforme unique et légère ;
- en s’intégrant aux outils PSA pour synchroniser la documentation dans l’ensemble de vos outils.
Guide de démarrage rapide
Suivi des tendances dans Jira
NinjaOne applique une méthode systématique pour consigner et suivre les problèmes clients « edge case » :
- un type de ticket Jira spécifique est utilisé pour suivre les tendances observées dans les tickets ;
- l’objectif est de repérer rapidement les problèmes émergents que les tickets d’investigation ou de bug classiques ne captent pas ;
- caractéristiques clés du suivi des tendances :
- il porte sur le comportement attendu à l’instant présent ;
- il vise à relier et regrouper les problèmes similaires ;
- il nécessite un échange avec la direction du support ;
- il doit déboucher sur des actions concrètes.
Exemple de suivi des tendances
Cela peut prendre la forme suivante :
- constater une augmentation des échecs de connexion à distance avec Ninja Remote ;
- suivre des problèmes tels que l’impossibilité de planifier des groupes de correctifs sur une même politique.
Recommandation
Si vous cherchez à consigner et réutiliser les problèmes clients de façon systématique, le suivi des tendances dans Jira mis en place par NinjaOne constitue une solution solide pour conserver le contexte des incidents et détecter des tendances plus larges.
Automatisez la gestion des cas limites pour gagner en efficacité opérationnelle
Une documentation des bugs rigoureuse tient compte des bugs edge case en s’appuyant sur un cadre complet. Cette pratique renforce la résilience opérationnelle sur le long terme et, avec les bons outils, vous pouvez traiter chaque incident dans son contexte tout en automatisant la traçabilité depuis un panneau de contrôle centralisé.
Sujets connexes :