Die wichtigsten Punkte
- Risikobasierte Patch-SLAs festlegen: Definieren Sie Patch-Fristen und Ausnahmerichtlinien anhand von Software-Stufen, Schweregrad und geschäftlichen Auswirkungen.
- Deployment-Ringe für Sicherheit nutzen: Rollen Sie Patches in gestaffelten Ringen aus, um die Stabilität zu prüfen und Störungen zu verringern.
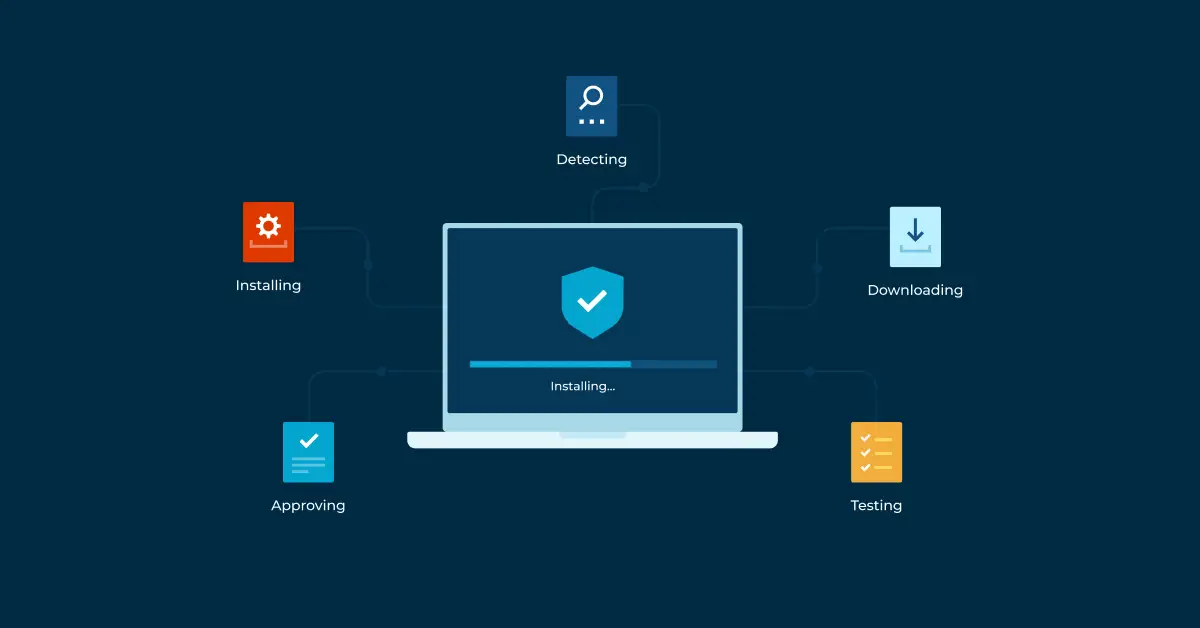
- Patch-Workflows automatisieren: Automatisieren Sie Freigaben, Zeitpläne und Sandbox-Tests, um das Patching zu straffen und manuelle Verzögerungen zu begrenzen.
- Compliance-Kennzahlen verfolgen: Überwachen Sie Installationszeiten, SLA-Erfüllung und Fehlerquoten, um dauerhaft Transparenz und Kontrolle zu behalten.
- Ausnahmen kontrollieren und beenden: Dokumentieren Sie Ausnahmen, benennen Sie Verantwortliche, setzen Sie Ablaufdaten durch und wenden Sie kompensierende Kontrollen an, um Risiken zu steuern.
Patch-SLAs legen Sie fest, indem Sie Assets nach Geschäftsrisiko in Stufen einteilen, jeder Stufe abhängig vom Schweregrad eine Patch-Frist zuweisen und einen Ausnahmeprozess aufbauen, in dem jede Abweichung eine verantwortliche Person und ein Ablaufdatum erhält. IT-Teams und Managed Service Provider (MSPs) können mit dieser risikobasierten Struktur ihr Patching konsistent, prüfbar und stabil gegenüber Abweichungen halten, selbst wenn sich Ausnahmen häufen.
Dieser Praxisleitfaden liefert ein Framework für wirksames Patch-Management, das auf Automatisierung, herstellerseitig definierten Best Practices und kontinuierlicher Kontrolle basiert. Das Ergebnis ist eine dauerhafte Abdeckung bei der Behebung von Schwachstellen, die auch Sonderfälle und Ausnahmen berücksichtigt.
Der Zusammenhang zwischen Service Level Agreements (SLAs) und Patch-Management
Ein Service Level Agreement (SLA) formalisiert die Beziehung zwischen einem MSP und seinen Kund:innen. Es legt Ihre Rolle fest, einschließlich der konkreten Leistungen, die Sie zusagen, sowie Kennzahlen zu deren Zuverlässigkeit und Verfügbarkeit. SLAs schaffen Vertrauen und sorgen dafür, dass der Leistungsumfang klar und vorab definiert ist.
Patch-Management spielt eine wichtige Rolle bei den Leistungen, die MSPs für ihre Kund:innen erbringen. Software konsequent zu aktualisieren schützt vor Cyberbedrohungen und hilft Unternehmen dabei, die Compliance-Anforderungen zahlreicher Datenschutz-Frameworks zu erfüllen. Unternehmen erwarten, dass Schutzmaßnahmen, Minderungen und Lösungswege für die Cybersicherheit in ihren SLAs dokumentiert sind.
Das brauchen Sie für realistische Ziele im Patch-Management
Für eine wirksame Patch-Compliance und darauf aufbauende, realistische SLAs benötigen Sie:
- Dokumentierte Software-Asset-Stufen und Wartungsfenster
- Patch Notes samt Schweregrad der Schwachstellen und Listen vertrauenswürdiger Anbieter
- Werkzeuge für Patch-Bereitstellung und Automatisierung, die gestaffelte Ringe und automatisiertes Rollback unterstützen
- Eine zentrale Plattform für IT-Dokumentation, in der Sie monatliche Kennzahlen und ein Ausnahmeregister ablegen
Beachten Sie: Das Framework in diesem Leitfaden ist nicht allgemeingültig. Sie müssen es an die jeweilige Umgebung Ihrer Kund:innen anpassen und dabei interne Richtlinien ebenso berücksichtigen wie alle relevanten Datenschutzgesetze, die für das Unternehmen oder dessen Kundschaft gelten.
Auf einen Blick
| Schritt | Funktion | Anwendbar bei |
| Risikobasierte SLAs definieren | Legt Patch-Fristen und Ausnahmeregeln nach Asset-Stufe und Schweregrad fest | Aufbau oder Aktualisierung grundlegender SLAs |
| Deployment-Ringe nutzen | Verteilt Patches zunächst an eine kleine Gruppe, bevor sie breiter ausgerollt werden | Prüfung der Patch-Stabilität vor dem vollständigen Rollout |
| Freigaben nach Klasse automatisieren | Genehmigt risikoarme Updates automatisiert und hält risikoreiche zur Prüfung zurück | Reduzierung des manuellen Freigabeaufwands |
| Abdeckung und Zuverlässigkeit überwachen | Verfolgt Installationsdauer, SLA-Einhaltung und Rollback-Rate | Laufende Berichterstattung zu SLAs und Zuverlässigkeit |
| Ausnahmen steuern | Weist jeder SLA-Ausnahme eine verantwortliche Person und ein Ablaufdatum zu | Umgang mit Abweichungen von Standard-SLAs |
| Monatliches Nachweispaket erstellen | Dokumentiert die SLA-Einhaltung und offene Ausnahmen | Berichterstattung an Kund:innen oder Stakeholder |
Schritt 1: Risikobasierte SLAs und Ziele für das Patch-Management definieren
Definieren und tabellieren Sie Software-Asset-Stufen, einschließlich ihrer Bedeutung für die grundlegende IT-Verfügbarkeit und den Geschäftsbetrieb. Legen Sie für jede Stufe fest, wie schnell Patches ausgerollt werden müssen, wie Notfallfreigaben ablaufen und welche Teammitglieder Ausnahmen genehmigen dürfen.
Orientieren Sie diese Vorgaben an der konkreten Software jeder Stufe, einschließlich der Herstellerempfehlungen zum Patching und der erwarteten Wartungsfenster auf Basis der Nutzung.
Sie könnten etwa eine Stufe mit hoher Priorität einrichten, in der kritische, nach außen erreichbare Software über Nacht automatisiert gepatcht und getestet wird, während Produktivitätssoftware ohne akute Risiken, die Mitarbeiter:innen benötigen, nach einem Kompatibilitätstest mit anderen Tools in Wochenendfenstern gepatcht wird. Auch Notfallfreigaben außerhalb der gestuften Richtlinien (etwa das Patchen von Software unter aktiver Ausnutzung, wie einem E-Mail-Server) sollten sorgfältig geplant werden.
Definieren Sie darauf aufbauend Ihre SLAs sowie eine Richtlinie für Ausnahmen einschließlich Notfallreaktion und stellen Sie sicher, dass eine berechtigte Person zeitnah für Freigaben verfügbar ist. Heben Sie Ausnahmen hervor, die dazu führen können, dass veraltete Software produktiv im Einsatz bleibt (zum Beispiel, wenn eine Person aus Kompatibilitätsgründen eine ältere Version eines Office-Pakets benötigt).
Erfahren Sie, wie Sie Schwachstellen priorisieren und die Lücke zwischen Erkennung und Behebung schließen
⬇️ Laden Sie den unverzichtbaren Leitfaden von NinjaOne zum Schwachstellenmanagement herunter
Schritt 2: Mit Ring-Deployment den Schaden begrenzen
Gestaffelte Rollouts über Deployment-Ringe ermöglichen es Ihnen, auf bekannte, funktionierende Konfigurationen zurückzusetzen, wenn ein Software-Patch mehr Probleme schafft als löst. Benennen Sie auf Basis der oben festgelegten Stufen eine kleine Pilotgruppe für erste Tests und erweitern Sie dann schrittweise auf Ringe mit einer größeren Bandbreite an Geräten und Konfigurationen, bis eine verlässliche Erfolgsquote erreicht ist und nachweislich keine bekannten Probleme auftreten.
Achten Sie genau auf Patch Notes und Hersteller-Best-Practices zum Patching und stellen Sie sicher, dass Ihre automatisierten Patch-Abläufe diese erkennen und berücksichtigen.
Schritt 3: Freigaben und Zeitpläne nach Klasse automatisieren
Priorisieren und automatisieren Sie Sicherheitsupdates, wenn das Risiko ungepatchter Systeme größer ist als das eines möglichen Patch-Problems. Risikoreiche Updates wie Treiber, Firmware und größere Funktionsupdates für Betriebssystem oder Anwendungen sollten zur Prüfung zurückgehalten werden, um Serviceunterbrechungen zu vermeiden. Richten Sie Patch- und Wartungsfenster an den Geschäftszeiten und den Auswirkungen auf Endbenutzer:innen aus und geben Sie diesen über Hinweise oder Kulanzzeiten die Möglichkeit, ihre Arbeit vor einem Neustart abzuschließen.
KI-gestütztes Patch-Management kann dabei helfen, indem es potenziell riskante Patches automatisiert markiert, Tests in einer Sandbox ausführt und Ihrem IT-Team Zusammenfassungen für fundierte Entscheidungen liefert.
Schritt 4: Abdeckung und Zuverlässigkeit überwachen
Nutzen Sie Ihre RMM-Plattform (Fernverwaltung und Überwachung), um drei zentrale Kennzahlen zu verfolgen:
- Mittlere Installationsdauer nach Stufe/Schweregrad
- SLA-Einhaltung
- Fehler- oder Rollback-Rate je Deployment-Ring
Diese Informationen lassen sich zu Monatsberichten zusammenfassen, mit denen Sie Assets und Stufen erkennen, die Patch-Fenster und SLA-Ziele regelmäßig verfehlen. Ebenso erkennen Sie Anbieter, die dabei überproportional vertreten sind (was Anpassungen an ihren Stufen oder ihrer Einordnung erfordern kann), sowie Softwareversionen mit eigenen Problemen, die Workarounds oder Minderungen nötig machen.
Prüfen Sie Ihre Berichte regelmäßig, um sicherzustellen, dass die Abdeckung vollständig ist, Ausnahmen und Notfallreaktionen begründet sind und die Zuverlässigkeit erhalten bleibt.
Schritt 5: Ausnahmen mit Ablaufdatum und kompensierenden Kontrollen steuern
Dokumentieren Sie alle Notfallmaßnahmen und Ausnahmen, die Schritte zu ihrer Umsetzung und das, was nötig ist, um sie wieder aufzuheben. Weisen Sie jede Ausnahme einem Mitglied Ihres IT-Teams zu und legen Sie ein Ablaufdatum fest. Setzen Sie das entweder über eine Automatisierung durch, die die Ausnahme zurücknimmt, oder über die automatisierte Erstellung oder Eskalation eines Tickets, falls es manuell geschehen muss.
Jede Ausnahme sollte auf ihre Sicherheitsauswirkungen hin bewertet werden, und es sollten Maßnahmen zu deren Minderung ergriffen werden (zum Beispiel zusätzliche Firewall-Regeln), bis die Software aktualisiert werden kann. Auch diese sollten dokumentiert werden, damit sie wieder abgebaut werden können und sich keine Ausnahmen und nicht mehr benötigten Kontrollen ansammeln.
Schritt 6: Ein monatliches Nachweispaket erstellen
Nutzen Sie Ihre Werkzeuge für IT-Automatisierung und Dokumentation, um automatisiert Monatsberichte zu erzeugen und zu veröffentlichen, die Ihre SLA-Einhaltung nach Stufe und die Erfolgsquote beim Patching belegen. Führen Sie darin jede noch nicht gepatchte Software und den Grund dafür auf (etwa Ausnahmen, ausstehende Tests oder das Warten auf ein passendes Wartungsfenster).
Solche Berichte verbessern die Kundenbeziehung, weil sie zeigen, wie SLA-Ziele erreicht werden und mit welchen Verbesserungen Software künftig noch schneller gepatcht wird, ohne die Produktivität zu beeinträchtigen.
Sehen Sie, wie richtlinienbasiertes Patching, Freigaben, Berichterstattung und Automatisierung in NinjaOne funktionieren
NinjaOne verbindet Automatisierung und Kontrolle in der Patch-Compliance
Patch-Management ist eine ständige Gratwanderung: die Kontrolle behalten und kritische Patches ausrollen, ohne Geschäftsabläufe zu stören, verlangt von IT-Teams viel Fingerspitzengefühl.
NinjaOne automatisiert das Patch-Management als Teil seiner IT-Plattform, die Überwachung, Verwaltung, Sicherheit, Backup und Support-Automatisierung ebenso vereint wie Werkzeuge für den Kundenerfolg. Sie können Regeln festlegen, die kritische Sicherheitspatches vertrauenswürdiger Anbieter automatisiert freigeben, offene Aufgaben verfolgen und Tickets bei SLA-Verstößen erstellen sowie das Ablaufen von Ausnahmen und Minderungsmaßnahmen automatisieren. Monatsberichte lassen sich automatisiert aus den Daten der Endpunkte erzeugen. So ist die Automatisierung durch vollständige Kontrolle abgesichert, und die Daten sind auch für Stakeholder im Unternehmen verständlich, die so den Nutzen eines aktuellen Softwarestands erkennen.
Quick-Start-Guide
Funktionen für Patch-SLAs und Risikomanagement
Optionen für die Patch-Freigabe
NinjaOne bietet mehrere Ebenen für Patch-Management und Risikosteuerung:
1. Freigabeebenen:
, Globale vorgelagerte Freigaben/Ablehnungen
, Freigaben/Ablehnungen auf Richtlinienebene
, Überschreibungen auf Geräteebene
2. Risikobasierte Freigabemethoden:
, Patches nach einer festgelegten Anzahl von Tagen freigeben (bis zu 30 Tage bei Standardupdates, 365 Tage bei Funktionsupdates)
, Patches manuell freigeben oder ablehnen
, KI-gestützte Patch Intelligence zur Risikoerkennung
Patch Intelligence KI
, Bewertet Windows-Patches alle sechs Stunden
, Kann Patches automatisiert zwischen Zuständen verschieben:
, Freigegeben
, Manuelle Freigabe
, Abgelehnt
, Berücksichtigt bekannte Probleme und Rückmeldungen aus der Community
CVE- und Schwachstellenbewertung
, Integriertes Common Vulnerability Scoring System (CVSS)
, Kategorisiert Schwachstellen:
, Kritisch: CVSS 9,0–10,0
, Hoch: CVSS 7,0–8,9
, Mittel: CVSS 4,0–6,9
, Niedrig: CVSS 0,1–3,9
Steuerung von Ausnahmen
, Überschreibungen auf Geräte- oder Richtlinienebene erstellen
, Patches manuell freigeben/ablehnen nach:
, KB-Nummer
, Patch-ID
, Patches mit Rollback-Unterstützung deinstallieren
, Spezifische Regeln für die Patch-Freigabe festlegen
Best Practices
, Kritische Updates zuerst an einer kleinen Auswahl von Geräten testen
, Ring-Deployments nutzen, um Patch-Rollouts zu staffeln
, Ergebnisse der Patch-Bereitstellung überwachen
, Die Verteilung anhand der ersten Ergebnisse anpassen
NinjaOne bietet einen umfassenden Ansatz für das Patch-Management mit granularer Kontrolle über Patch-SLAs, Risikobewertung und den Umgang mit Ausnahmen.