Belangrijkste punten
- Broadcast storms overbelasten netwerken: overmatig broadcastverkeer kan de bandbreedte en de CPU van switches verzadigen wat leidt tot latency, pakketverlies of storingen.
- Switching loops als belangrijkste oorzaak: wanneer switches op meerdere manieren met elkaar zijn verbonden zonder goede controles kan broadcastverkeer eindeloos blijven circuleren en zich razendsnel vermenigvuldigen.
- De impact loopt snel op: broadcast storms groeien exponentieel en verhogen de latency en het pakketverlies totdat normale netwerkcommunicatie stilvalt.
- Preventie draait om switchinstellingen: protocollen tegen loops en functies voor storm control kunnen broadcastverkeer begrenzen met behoud van redundantie.
- Segmentatie verkleint de blast radius: door netwerken op te delen in kleinere broadcastdomeinen blijven storingen beperkt en wordt de blast radius van een storing kleiner.
Als er in de IT-wereld weerberichten bestonden, zou één gebeurtenis meteen alle alarmbellen laten rinkelen: het nieuws van een broadcast storm. Net als hun naamgenoten kunnen deze netwerkproblemen alles razendsnel platleggen, vaak zonder enige waarschuwing.
Ze ontstaan wanneer broadcastverkeer zich ongecontroleerd vermenigvuldigt tot het de beschikbare bandbreedte opslokt en netwerkapparatuur overbelast. Wat begint als een eenvoudig frame waarmee devices elkaar kunnen ontdekken, groeit in korte tijd uit tot een vloedgolf van gedupliceerd verkeer die de normale communicatie volledig stillegt.
In deze gids beantwoorden we de vraag: “hoe ontstaat een broadcast storm en hoe voorkomt u er een?” Omdat broadcastframes bedoeld zijn om elk device in een netwerksegment te bereiken, kan zelfs een kleine loop binnen enkele seconden uitgroeien tot een complete storing. Het is dan ook essentieel dat IT-teams, zeker in sterk gereguleerde sectoren, weten hoe ze zo’n storm herkennen en voorkomen voordat die de bedrijfsvoering verstoort.
Voorkennis
Om het meeste uit deze gids te halen, is het handig als u basiskennis hebt van Ethernet-netwerken, van de werking van switches in een LAN en van broadcastdomeinen en VLAN’s.
U hoeft geen netwerkengineer te zijn, maar als u bekend bent met het dagelijkse gedrag van switches vallen de concepten sneller op hun plek.
Wat is een broadcast storm (en waarom escaleert die zo snel)?
In een Ethernet-netwerk zijn sommige berichten voor iedereen bestemd. Dat zijn broadcastberichten en ze worden gebruikt voor alledaagse taken zoals het vinden van devices of het omzetten van IP-adressen. Wanneer een switch een broadcast ontvangt, stuurt hij dat bericht door naar alle aangesloten devices in hetzelfde netwerksegment.
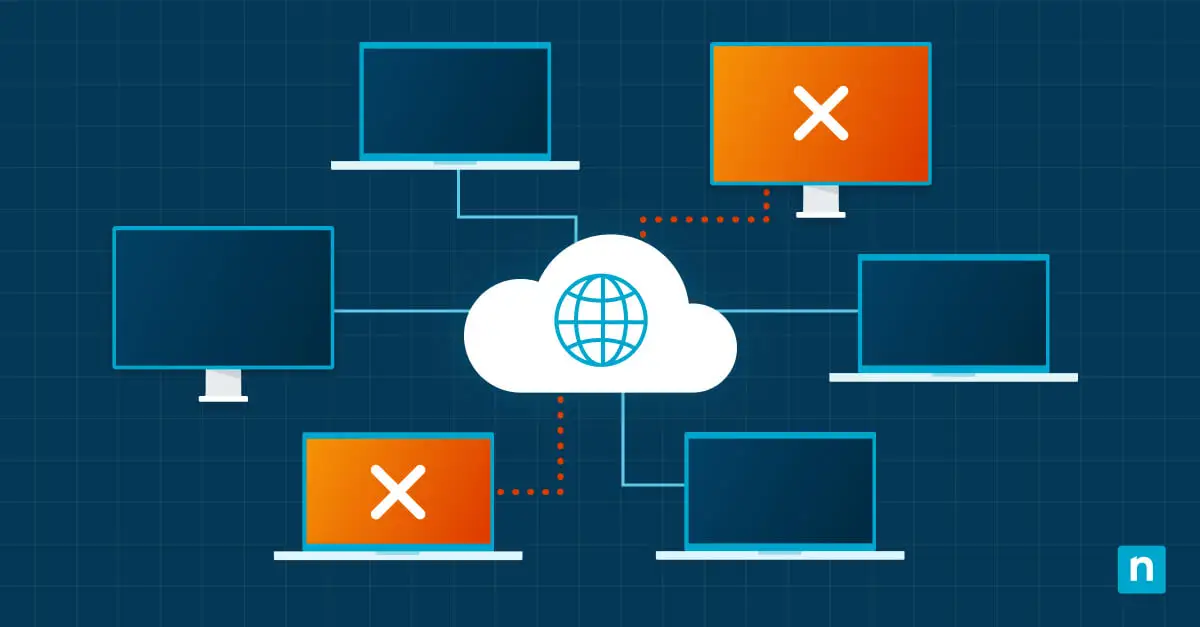
Een broadcast storm ontstaat wanneer diezelfde berichten keer op keer worden herhaald in plaats van te stoppen zodra ze hun werk hebben gedaan. Elke keer dat het bericht terugkomt stuurt de switch het opnieuw door waardoor er steeds meer kopieën bij komen.
Daarom zijn broadcast storms zo gevaarlijk. Anders dan gewone verkeerspieken vlakken ze niet af. Ze versnellen tot netwerkapparatuur het verkeer niet snel genoeg meer kan verwerken, met ernstige latency, pakketverlies en vaak een volledige netwerkstoring tot gevolg.
Zo veroorzaken switching loops een broadcast storm
Een switching loop ontstaat wanneer switches op meer dan één manier met elkaar zijn verbonden en het netwerk geen systeem heeft om die extra verbindingen te regelen. In plaats van één route voor het verkeer te kiezen sturen de switches berichten in een kringetje rond.
In de praktijk ziet dat er zo uit:
- Een broadcastbericht komt binnen op een switch en wordt naar alle andere verbindingen gestuurd.
- Eén van die verbindingen leidt naar een andere switch die precies hetzelfde doet.
- Uiteindelijk vindt het bericht via een andere kabel zijn weg terug naar de oorspronkelijke switch.
Omdat de switch het niet als duplicaat herkent, stuurt hij het bericht opnieuw door en blijft de loop doorgaan.
Elke ronde door de loop levert meer kopieën van hetzelfde bericht op. Hoe langer het duurt, hoe meer verkeer zich opstapelt en hoe sneller het netwerk overbelast raakt. Daarom zijn switching loops de meest voorkomende en gevaarlijkste oorzaak van broadcast storms.
Waarom switching loops actief beheerst moeten worden
Switching loops zijn van nature een veelvoorkomend neveneffect van het bouwen van betrouwbare netwerken. Extra kabels tussen switches aanleggen is een gangbare manier om de uptime te verbeteren, maar zonder iets dat die extra verbindingen regelt weet het netwerk niet welk pad het verkeer moet volgen.
In dat geval doen switches precies waarvoor ze zijn gemaakt: verkeer zo efficiënt mogelijk doorsturen. Broadcastverkeer kent helaas geen ingebouwd “stop”-signaal. Zodra het in een loop terechtkomt, blijft het circuleren en zich vermenigvuldigen. Zo kan een simpele bekabelings- of configuratiefout in korte tijd uitmonden in een broadcast storm.
Wat zijn protocollen tegen loops?
Protocollen tegen loops zijn ingebouwde veiligheidsmechanismen die voorkomen dat switches verkeer per ongeluk in cirkels rondsturen. Ze maken het mogelijk om extra kabels en reservepaden aan te houden voor de betrouwbaarheid terwijl er telkens maar één logisch pad in gebruik is. Zonder deze protocollen zouden switching loops normaal broadcastverkeer snel veranderen in een broadcast storm.
De meest gebruikte protocollen tegen loops in Ethernet-netwerken zijn de volgende:
Spanning Tree Protocol (STP)
Spanning Tree Protocol is het oorspronkelijke en breedst ondersteunde protocol tegen loops. Het brengt in kaart hoe switches met elkaar verbonden zijn en blokkeert vervolgens de redundante verbindingen die loops zouden kunnen veroorzaken. Valt een actieve verbinding weg, dan kan STP een reservepad deblokkeren om de connectiviteit te herstellen, al kan dat proces enkele seconden duren.
Rapid Spanning Tree Protocol (RSTP)
Rapid Spanning Tree Protocol is een verbeterde versie van STP die veel sneller reageert op netwerkwijzigingen. Het gebruikt slimmere detectiemethoden om reserveverbindingen bij een storing snel weer in te schakelen waardoor de uitvaltijd afneemt. Voor de meeste moderne netwerken heeft RSTP de voorkeur omdat het bescherming tegen loops biedt zonder langdurige onderbrekingen.
Multiple Spanning Tree Protocol (MSTP)
Multiple Spanning Tree Protocol is ontworpen voor grotere of complexere netwerken met meerdere VLAN’s. In plaats van het hele netwerk als één boom te behandelen laat MSTP verschillende VLAN-groepen verschillende actieve paden gebruiken. Dat verhoogt de efficiëntie en voorkomt tegelijk switching loops en broadcast storms.
Zo herkent u een broadcast storm in een vroeg stadium
Broadcast storms komen zelden uit het niets. Meestal vertoont het netwerk al signalen voordat alles plat gaat.
Veelvoorkomende waarschuwingssignalen zijn:
- Het hele netwerk voelt ineens traag aan, niet slechts één systeem.
- Applicaties lopen vast in time-outs of gedragen zich wisselend.
- Switches vertonen een ongewoon hoog CPU-gebruik.
- Netwerkverbindingen lijken druk bezet terwijl gebruikers nauwelijks iets doen.
Omdat broadcast storms hele netwerksegmenten treffen, is de impact meestal breed voelbaar. Monitoringtools die verkeersniveaus en apparaatgezondheid bijhouden helpen om afwijkende patronen vroeg te signaleren zodat u kunt ingrijpen voordat er een volledige storing ontstaat. U kunt ook switches monitoren met NinjaOne.
Netwerken ontwerpen die de schade beperken
Eén van de eenvoudigste (en aantoonbaar beste) manieren om een netwerk zo te ontwerpen dat de schade van broadcast storms beperkt blijft, is segmentatie.
Zie segmentatie als het plaatsen van muren in een gebouw. In plaats van één grote open ruimte waarin een brand zich overal kan verspreiden, deelt u de ruimte op in kleinere kamers. In netwerken doen VLAN’s precies dat: ze verdelen een netwerk in kleinere delen zodat broadcastverkeer binnen de perken blijft.
Treedt er binnen zo’n deel een broadcast storm op, dan blijft die daar gevangen. Devices buiten dat VLAN ondervinden er geen hinder van, waardoor minder gebruikers getroffen worden en het oplossen van problemen een stuk eenvoudiger wordt.
Ook andere ontwerpkeuzes spelen een grote rol bij het beheersbaar houden van problemen:
- Gebruik managed switches met ingeschakelde bescherming tegen loops. Zo kan het netwerk automatisch paden blokkeren waardoor verkeer eindeloos zou blijven rondgaan.
- Stel limieten in voor broadcast- en multicastverkeer op accesspoorten. Dat voorkomt dat één device het netwerk overspoelt met overmatig verkeer.
- Vermijd unmanaged switches in productienetwerken. Dat verkleint het risico op onbedoelde loops, omdat unmanaged devices meestal geen veiligheidsfuncties hebben.
- Houd de netwerkindeling gedocumenteerd om onbedoelde loops te voorkomen. Dat helpt fouten bij wijzigingen te voorkomen, zoals het aansluiten van een kabel die een ongewenste loop creëert.
Welke methode u of uw IT-team ook kiest, het doel is indamming. Blijven broadcast storms beperkt tot een klein gebied, dan zijn ze makkelijker te diagnosticeren en veel minder verstorend.
Overige aandachtspunten
Switching loops zijn weliswaar de meest voorkomende oorzaak van broadcast storms, maar niet de enige. In echte netwerken kunnen allerlei kleinere problemen samen het broadcastverkeer uit de hand laten lopen. Devices die verkeerd geconfigureerd zijn of niet goed werken genereren eveneens veel meer broadcastverkeer dan verwacht. Ook multicastverkeer kan zich vergelijkbaar gedragen en het netwerk overbelasten als het niet goed wordt beheerd.
In omgevingen met veel printers, IoT-devices, camera’s of andere unmanaged hardware ligt het basisniveau van broadcastverkeer vaak al hoger. Daardoor is er minder ruimte voor fouten en worden preventieve maatregelen nog belangrijker.
Problemen oplossen bij een vermoedelijke broadcast storm
Wanneer er een broadcast storm aan de gang is, zijn de symptomen meestal breed voelbaar in plaats van beperkt tot één device. Ga niet gokken, maar let eerst op deze veelvoorkomende signalen:
- Plotselinge traagheid in het hele netwerk waarbij meerdere gebruikers of systemen tegelijk getroffen worden
- Ongewoon veel broadcast- of multicastverkeer op switches, vaak een teken van overmatige duplicatie.
- Pieken in het CPU-gebruik van switches, doordat switches te veel tijd besteden aan het verwerken van herhaalde frames
Let daarnaast op aanwijzingen die duiden op een fysiek of topologisch probleem:
- Verbindingen met een hoge bezetting zonder duidelijke oorzaak, zoals zwaar gebruik buiten kantooruren
- Onderbrekingen die komen en gaan of verbindingen die blijven flappen, wat kan wijzen op een loop die steeds opnieuw ontstaat en verbroken wordt.
- Recente wijzigingen in bekabeling of hardware, waaronder nieuw toegevoegde switches of kabels, kunnen een onbedoelde loop hebben veroorzaakt.
Samen wijzen deze symptomen sterk op een broadcast storm en vormen ze aanleiding om de switchconfiguraties meteen na te lopen.
Zo helpt NinjaOne bij het voorkomen van netwerkloops
NinjaOne helpt IT-teams broadcast storms te signaleren en erop te reageren door netwerkactiviteit samen te brengen in één centraal overzicht.
- Monitoring van afwijkend netwerkgedrag: het Network Management System van NinjaOne (NMS) geeft inzicht in verkeerspatronen, connectiviteitsproblemen en apparaatprestaties waardoor ongewone pieken in broadcast- of multicastverkeer eenvoudiger te detecteren zijn.
- Centraal inzicht in alle devices: gegevens van gemonitorde endpoints en netwerkapparatuur worden samengebracht in een enkel dashboard zodat beheerders snel zien welke systemen of netwerksegmenten getroffen zijn in plaats van blind te moeten zoeken.
- Analyse van verkeersstromen: NinjaOne ondersteunt NetFlow, sFlow en jFlow waarmee teams begrijpen hoe verkeer zich door het netwerk beweegt en waar overmatig of afwijkend verkeer vandaan komt.
- Betere detectie van afwijkingen: SNMP-monitoring, het verzamelen van syslogs en controles van de apparaatgezondheid geven extra context en helpen verkeerspieken te koppelen aan hardwareproblemen, interfacefouten of recente configuratiewijzigingen.
- Sneller reageren op storingen: realtime notificaties en gedetailleerde analytics stellen teams in staat onderzoek te doen en in te grijpen voordat een broadcast storm uitgroeit tot een volledige netwerkstoring.
Quick-start guide
NinjaOne helpt broadcast storms te voorkomen via verschillende mechanismen:
- Netwerkmonitoring: de netwerkmonitoring van NinjaOne houdt netwerkapparatuur doorlopend in de gaten en kan u waarschuwen bij ongewone verkeerspatronen die op een broadcast storm kunnen wijzen.
- Controles van de apparaatgezondheid: de software voert regelmatige gezondheidscontroles uit op devices waarmee verkeerd geconfigureerde of defecte devices die broadcast storms kunnen veroorzaken sneller aan het licht komen.
- Beleidshandhaving: u kunt beleid opstellen om het gedrag van devices te beheren zodat devices zich aan de juiste netwerkconfiguraties houden.
De IT management software van NinjaOne kent geen verplichte contracten en geen verborgen kosten. U kunt een gratis offerte aanvragen, een gratis trial van 14 dagen inplannen of een demo bekijken.
Een switching loop voorkomen
Switching loops zijn een van de meest voorkomende oorzaken van broadcast storms, maar ook een van de makkelijkst te voorkomen problemen.
Het draait om een paar basisprincipes: netwerken doordacht ontwerpen, switches configureren met bescherming tegen loops en verkeerscontroles en het netwerkgedrag in de gaten houden. Met die waarborgen op orde is de kans veel kleiner dat kleine fouten uitgroeien tot grote storingen.
Gerelateerde onderwerpen: