Schlüsselpunkte
- Netzwerkredundanz verringert Ausfallzeiten, indem sie Single Points of Failure bei Verbindungen, Geräten, Pfaden und Providern beseitigt.
- Wer Redundanz schrittweise einführt und mit dem Schutz auf Verbindungsebene beginnt, erzielt große Wirkung bei überschaubarer Komplexität.
- Ein gutes Redundanzdesign verbindet Zuverlässigkeit mit Praxistauglichkeit, indem es die Redundanz-Ebenen an den geschäftskritischen Risiken ausrichtet.
Ein einzelner Ausfallpunkt kann weitreichende Störungen verursachen, sobald eine Verbindung, ein Gerät oder ein Netzwerkanbieter offline geht. Netzwerkredundanz beugt genau dem vor, indem sie alternative Pfade bereitstellt, die die Konnektivität aufrechterhalten. Dieser Leitfaden erklärt, was Netzwerkredundanz ist, warum sie wichtig ist und wie Sie sie wirksam umsetzen.
Was ist Netzwerkredundanz?
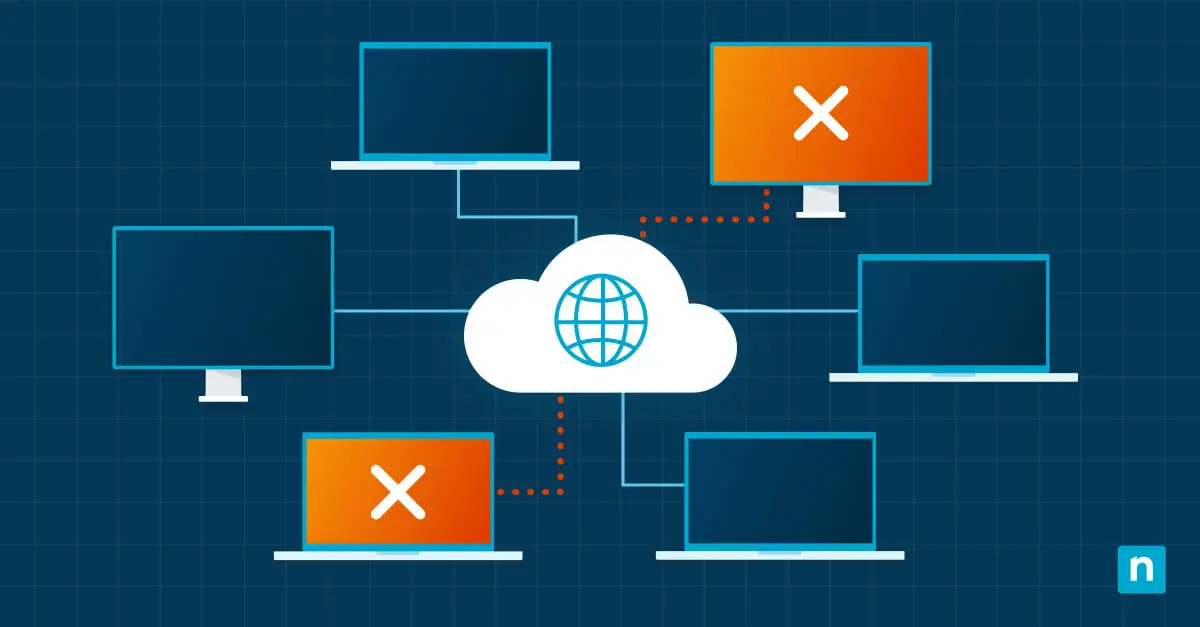
Netzwerkredundanz bedeutet, ein Netzwerk mit Backup-Komponenten, alternativen Datenpfaden und Failover-Mechanismen zu planen und zu konfigurieren, damit Konnektivität und Services auch dann verfügbar bleiben, wenn ein Teil des Netzwerks ausfällt. Statt sich auf ein einzelnes Gerät, eine einzelne Verbindung oder einen einzelnen Provider zu verlassen, verteilen redundante Netzwerke das Risiko auf mehrere Ressourcen und sichern so Verfügbarkeit und Geschäftskontinuität.
Die verschiedenen Arten von Netzwerkredundanz
Es gibt mehrere Arten von Netzwerkredundanz, die jeweils vor bestimmten Ausfallszenarien schützen:
- Verbindungsredundanz, nutzt mehrere physische oder logische Verbindungen zwischen Geräten, um Ausfälle durch defekte Kabel oder Schnittstellen zu verhindern.
- Geräteredundanz, stellt Backup-Hardware wie Switches, Router oder Firewalls bereit, damit der Betrieb beim Ausfall eines primären Geräts weiterläuft.
- Pfadredundanz, schafft mehrere Routing-Pfade im Netzwerk, sodass der Datenverkehr automatisiert umgeleitet wird, wenn ein primärer Pfad nicht mehr verfügbar ist.
- Stromredundanz, setzt auf Ersatzstromquellen wie doppelte Netzteile, Unterbrechungsfreie Stromversorgung (UPS) oder Generatoren, damit Netzwerkkomponenten bei Stromausfall weiterlaufen.
- ISP-Redundanz, bindet mehrere Internetanbieter an, um sich gegen externe Konnektivitätsausfälle abzusichern.
- Geografische Redundanz, verteilt die Infrastruktur auf verschiedene physische Standorte und senkt so Risiken durch Umwelteinflüsse oder regionale Störungen.
Netzwerkredundanz umsetzen und Ausfallzeiten reduzieren
Dieser Leitfaden setzt ein grundlegendes Verständnis von Netzwerkkonnektivität und Vertrautheit mit Standardkomponenten wie Switches und Routern voraus. Passen Sie die Schritte an die Anforderungen oder Grenzen Ihrer geschäftskritischen Services an.
Schritt 1: Verstehen, wovor Netzwerkredundanz schützt
Beim Aufbau von Netzwerkredundanz kommt es darauf an, Komplexität und Zuverlässigkeit in Einklang zu bringen. Aus Effizienz- und Praxisgründen beginnen Sie am besten damit, die Ausfallarten zu identifizieren, die die Netzwerkverfügbarkeit in Ihrem Stack stören können.
| Art des Ausfalls | Auswirkung auf die Netzwerkverfügbarkeit |
| Hardwareausfall | Switches, Router oder Netzwerkschnittstellen fallen aus und unterbrechen den Datenfluss. |
| Verbindungsausfall | Beschädigte Kabel oder Schnittstellenprobleme unterbrechen die Verbindung zwischen Geräten. |
| Provider-Ausfall | Störungen beim ISP führen zum Verlust der Internet- oder WAN-Konnektivität. |
| Konfigurationsfehler | Falsche Routing- oder Firewall-Änderungen stören die normalen Verkehrswege. |
| Stromausfall | Ein Stromausfall nimmt Netzwerkgeräte oder Verbindungen offline. |
| Umgebungsbedingte Störung | Kühlung, Feuer oder physische Schäden beeinträchtigen die Netzwerkinfrastruktur. |
Wenn Sie wissen, welche Ausfallarten am wahrscheinlichsten sind, erkennen Sie, wo Netzwerkredundanz in Ihrer Umgebung den größten Nutzen bringt.
Schritt 2: Redundanz auf Verbindungsebene umsetzen
Mit Verbindungsredundanz beginnen Sie in der Regel, weil sie günstig und risikoarm ist. Außerdem fängt sie Ausfälle ab, die durch einzelne Kabel- oder Schnittstellendefekte entstehen, und das sind in den meisten Umgebungen recht häufige Schwachstellen.
Dabei richten Sie mehrere physische Verbindungen zwischen Geräten oder Netzwerksegmenten ein, damit der Datenverkehr weiterfließt, wenn eine Verbindung ausfällt. Die Ausfallsicherheit steigt zusätzlich, wenn Sie nach Möglichkeit physisch getrennte Wege wählen und dort, wo es unterstützt wird, Link Aggregation aktivieren.
Schritt 3: Redundanz auf Geräteebene ergänzen
Redundanz auf Geräteebene erfordert eine bewusstere Investition, bietet dafür aber auch mehr Schutz in Ihrem Verantwortungsbereich.
Dieser Schritt sichert die Geschäftskontinuität selbst dann, wenn kritische Hardware wie Switches, Router oder Firewalls ausfällt. Statt sich auf ein einzelnes Gerät zu verlassen, sorgen redundante Paare dafür, dass der Datenverkehr weiterläuft, wenn eine Einheit nicht mehr verfügbar ist.
Beim Design für Geräteredundanz ist es üblich, für zentrale Netzwerkrollen und Übergabepunkte Ersatzgeräte bereitzustellen.
Schritt 4: Pfad- und Topologieredundanz aufbauen
Pfad- und Topologieredundanz sorgen dafür, dass der Datenverkehr sein Ziel über alternative Routen erreicht, auch wenn der primäre Pfad ausfällt. Das senkt das Risiko von Störungen durch einzelne Aggregationspunkte oder starre Netzwerkdesigns.
Schritt 5: ISP- und Internetredundanz umsetzen
ISP- und Internetredundanz schützen vor Ausfällen, die außerhalb Ihres internen Netzwerks auftreten. Für Unternehmensumgebungen und erst recht für IT-Dienstleister ist das eine unverzichtbare Absicherung. Wer sich auf einen einzigen Provider verlässt, geht ein Risiko ein, das sich durch interne Redundanz allein nicht abfedern lässt.
Schritt 6: Mit einfachen Redundanzmustern starten
Am schnellsten wirkt Redundanz im Netzwerk, wenn Sie mit dem planen, was bereits vorhanden ist. Statt das gesamte Netzwerk auf einmal neu zu entwerfen, beginnen Sie mit einfachen Redundanzmustern, die die kritischsten Risiken abdecken.
Schrittweise Verbesserungen lassen sich dann verteilen, wenn neue geschäftliche Anforderungen entstehen oder Ihre Bandbreite und Ressourcen wachsen. Eine schrittweise Ausweitung der Redundanz erleichtert zudem das Testen, Verwalten und Pflegen der Sicherheitskontrollen über die Zeit.
So entsteht eine widerstandsfähigere IT-Infrastruktur
Netzwerkredundanz ist ein wirksames Mittel, um Ausfallzeiten zu verringern und die Folgen unerwarteter Störungen zu begrenzen. Sie brauchen aber auch durchgängige Transparenz, Überwachung und regelmäßige Tests, damit Netzwerke und Systeme wie vorgesehen funktionieren, gerade wenn neue Bedrohungen auftauchen oder sich Umgebungen verändern.
Redundanzprotokolle in Kombination mit Automatisierung sind der Einstieg in ein effizientes IT-Management, vor allem wenn Sie Zuverlässigkeit erreichen wollen, ohne unnötige Komplexität zu schaffen. Setzen Sie für langfristige Resilienz auf Redundanzstrategien, die sich leicht verwalten lassen und sich an einer zentralen Software für IT-Sicherheit und -Management orientieren.
Verwandte Themen:
- 6 Best Practices für die Netzwerküberwachung
- Paketverlust beheben: So gehen Sie vor
- Netzwerksegmentierung: Definition und wichtigste Vorteile
- Software für Netzwerkanalysen: Übersicht und Beispiele
- Netzwerküberlastung diagnostizieren und beseitigen
Quick-Start-Guide
NinjaOne unterstützt Sie bei der Umsetzung von Netzwerkredundanz auf mehreren Wegen:
- Netzwerküberwachung und -management: NinjaOne bietet Funktionen zur Netzwerküberwachung, mit denen Sie mögliche Single Points of Failure erkennen und redundante Systeme einrichten können.
- Infrastrukturmanagement: Über die RMM-Funktionen von NinjaOne verwalten und überwachen Sie den Zustand redundanter Netzwerkkomponenten.
- Integration mit Netzwerk-Hardware: NinjaOne lässt sich mit Hardware verschiedener Netzwerkanbieter integrieren, sodass Sie redundante Netzwerkpfade und -geräte überwachen und verwalten können.
- Automatisierte Alarmierungen und Berichterstattung: Die Plattform sendet automatisierte Alarmierungen, wenn die Redundanz versagt oder es Probleme mit Failover-Systemen gibt.