



Die wichtigsten Punkte
- Definition und Zweck eines Failover-Clusters: Ein Failover-Cluster ist eine Gruppe von Servern (Knoten), die bei einem Ausfall Arbeitslasten automatisiert übernehmen, um Hochverfügbarkeit, minimale Ausfallzeit und Geschäftskontinuität zu gewährleisten.
- Zentrale Komponenten und Voraussetzungen: Nötig sind mehrere Knoten, eine Cluster-Management-Software, ein zuverlässiges Netzwerk und häufig gemeinsamer Speicher, um Ausfälle zu erkennen und ein nahtloses Failover auszulösen.
- So läuft Failover-Clustering ab (Schritte): Der Cluster überwacht fortlaufend den Zustand der Knoten → erkennt einen Ausfall → verlagert Dienste und Anwendungen automatisiert auf einen funktionierenden Knoten → nimmt den Betrieb mit minimaler Beeinträchtigung wieder auf.
- Typen und Konfigurationen von Failover-Clustern: Verbreitete Modelle sind Active-Active- und Active-Passive-Cluster sowie Shared-Disk- und Shared-Nothing-Architekturen, die jeweils Leistung, Kosten und Komplexität beeinflussen.
- Best Practices für zuverlässige Failover-Cluster: Beseitigen Sie einzelne Ausfallpunkte, testen Sie das Failover regelmäßig, halten Sie die Konfigurationen aller Knoten einheitlich und überwachen Sie die Leistung, um Widerstandsfähigkeit, Skalierbarkeit und Betriebszeit sicherzustellen.
Reibungslose Abläufe und widerstandsfähige Systeme gehören zu den zentralen Anforderungen moderner Unternehmens-IT. Und die Technologie hinter dem Failover-Cluster kann einen großen Beitrag dazu leisten, diese Ziele zu erreichen. Dieser Artikel geht dem Failover-Cluster auf den Grund und beleuchtet seine Funktionsweise sowie typische Einsatzgebiete. Egal, ob Sie erfahrene:r IT-Experte sind oder sich einfach für das Thema interessieren: Lesen Sie weiter. Wir zeigen Ihnen, wie Failover-Cluster im Detail aufgebaut sind, wie sie funktionieren und in welchen Szenarien sie unverzichtbar sind.
Was ist ein Failover-Cluster?
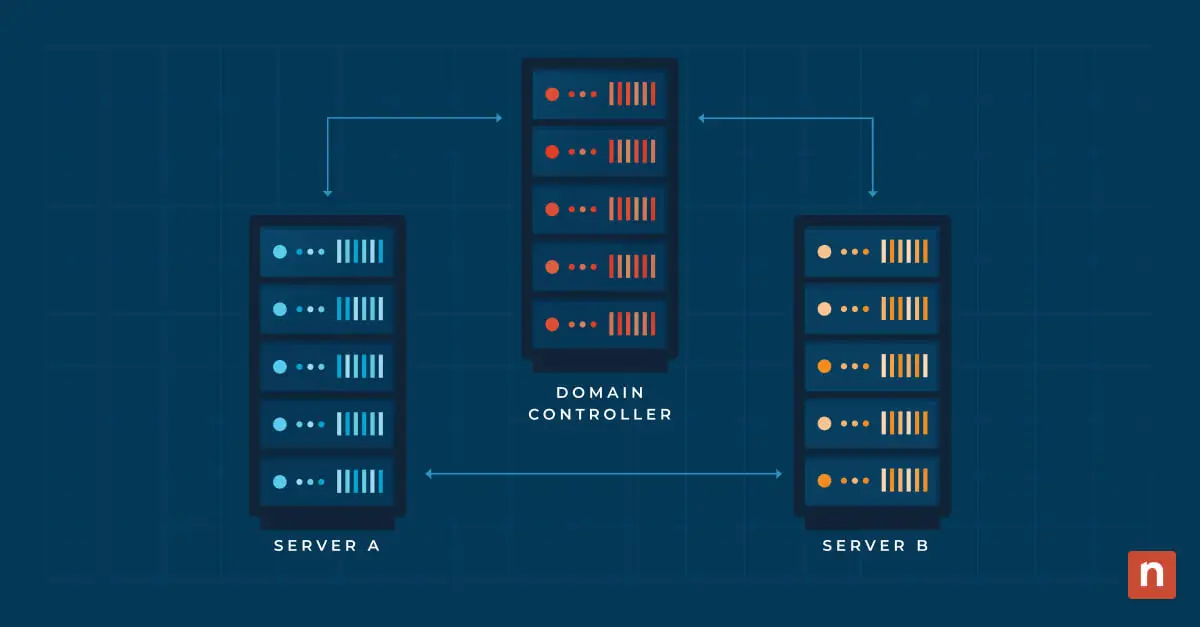
Ein Failover-Cluster ist eine spezielle Form der hochverfügbaren Infrastruktur. Er soll den unterbrechungsfreien Betrieb auch bei Hardware- oder Software-Ausfällen sicherstellen. Im Kern handelt es sich um eine Gruppe miteinander verbundener Computer, die als ein einziges System zusammenarbeiten. Ziel ist es, Redundanz und durchgehende Verfügbarkeit zu bieten. Die Hauptaufgabe eines Failover-Clusters besteht darin, den Ausfall einer Systemkomponente zu erkennen. Anschließend überträgt er die Arbeitslast automatisiert auf eine funktionierende Komponente, ohne dass Benutzer:innen eine spürbare Unterbrechung bemerken.
Zu den wichtigsten Bestandteilen eines Failover-Clusters zählen in der Regel mehrere Server (oder Knoten), gemeinsam genutzte Speicherressourcen und eine Cluster-Management-Software. Die Cluster-Management-Software überwacht den Zustand und Status der Knoten. Wird ein Ausfall erkannt, etwa eine Hardware-Störung, steuert die Cluster-Management-Software den Failover-Prozess. Dabei werden Arbeitslast und Zuständigkeiten vom ausgefallenen Knoten auf einen funktionsfähigen übertragen. Das Ziel: Dienste und Anwendungen bleiben erreichbar und einsatzbereit.
Stärken Sie Ihre operative Widerstandsfähigkeit mit den Tools von NinjaOne für die Notfallwiederherstellung.
Failover-Clustering mit Hochverfügbarkeit und mit durchgehender Verfügbarkeit
Hochverfügbarkeit bezeichnet die Fähigkeit eines Systems oder Dienstes, Ausfallzeiten zu minimieren, indem es sich schnell von Störungen erholt. Hochverfügbare Failover-Cluster erkennen einen Ausfall in der Regel selbst, starten den Failover-Prozess automatisiert und nehmen den Betrieb auf einem Standby-Knoten wieder auf. Ziel ist es, die Ausfallzeit auf ein Minimum zu reduzieren. So werden Dienste schnell wiederhergestellt, ohne dass es zu größeren Störungen kommt.
Failover-Cluster mit durchgehender Verfügbarkeit unterscheiden sich leicht davon: Hier liegt der Schwerpunkt darauf, den Dienst ohne Unterbrechung und mit minimaler bis gar keiner Ausfallzeit aufrechtzuerhalten. Durchgehende Verfügbarkeit bedeutet, dass Dienste nahtlos von einem ausgefallenen auf einen funktionierenden Knoten wechseln, sodass Endbenutzer:innen keine spürbare Unterbrechung erleben. Dafür ist normalerweise eine synchrone Datenreplikation auf den Standby-Knoten erforderlich.
Sicherheit und Schutz durch Redundanz
Redundanz ist ein grundlegendes Konzept beim Failover-Clustering. Gemeint sind doppelt vorhandene Komponenten oder Systeme innerhalb eines Clusters, die Zuverlässigkeit und Fehlertoleranz sicherstellen. Das wichtigste Ziel von Redundanz ist es, einzelne Ausfallpunkte zu beseitigen. Das sind Schwachstellen in einem System, die bei einer Störung zu Dienstunterbrechungen oder Datenverlust führen können. Beim Failover-Clustering spielt Redundanz deshalb eine entscheidende Rolle. Sie hält den Betrieb auch dann aufrecht, wenn eine oder mehrere Komponenten ausfallen.
In einem Failover-Cluster wird Redundanz auf verschiedene Weise umgesetzt:
- Knoten-Redundanz: Failover-Cluster bestehen aus mehreren Knoten, also einzelnen Servern, die als ein gemeinsames System zusammenarbeiten. Fällt ein Knoten wegen Hardware- oder Software-Problemen aus, übernehmen die übrigen Knoten im Cluster die Arbeitslast und verhindern so eine Ausfallzeit. Selbst wenn ein Server also nicht mehr verfügbar ist, können Dienste oder Anwendungen nahtlos auf einen anderen funktionierenden Knoten umschalten.
- Redundanz beim gemeinsamen Speicher: Cluster nutzen häufig gemeinsame Speicherressourcen wie Storage Area Networks (SANs), um konsistente Daten über alle Knoten hinweg vorzuhalten. Redundanz im gemeinsamen Speicher wird mit Technologien wie RAID (Redundant Array of Independent Disks) erreicht, die vor Festplattenausfällen schützen. So bleiben die Daten selbst beim Ausfall eines Speichergeräts über redundante Speichermechanismen zugänglich. Wenn Sie sich eingehender mit diesen Konzepten befassen möchten, inklusive praktischer Hinweise zur Implementierung von SANs und zu ihren Vorteilen, lesen Sie Was ist ein Storage Area Network (SAN)? Vorteile und Implementierung.
- Netzwerk-Redundanz: Die Kommunikation zwischen den Cluster-Knoten ist für Koordination und Datensynchronisation unverzichtbar. Netzwerk-Redundanz bedeutet, mehrere Netzwerkpfade und Schnittstellen vorzuhalten, damit der Cluster bei Ausfall einer Verbindung über alternative Pfade weiter kommunizieren kann. Das verhindert, dass Knoten isoliert werden, und sichert die durchgehende Verfügbarkeit.
- Strom- und Hardware-Redundanz: Redundante Netzteile, Kühlsysteme und weitere Hardware-Komponenten tragen zur Gesamtzuverlässigkeit des Failover-Clusters bei. Diese Maßnahmen schützen vor Ausfällen durch Stromunterbrechungen oder Hardware-Störungen.
Darum ist Failover-Clustering so wichtig
Failover-Clustering ist in der modernen IT-Infrastruktur von größter Bedeutung, denn es adressiert kritische Aspekte wie Hochverfügbarkeit und den durchgehenden Zugriff auf Daten und Dienste. Im Folgenden betrachten wir seine Bedeutung im Detail:
- Verfügbarkeit:
Hochverfügbarkeit ist entscheidend für Systeme und Anwendungen, die ständig erreichbar sein müssen. Indem Failover-Cluster Arbeitslasten auf mehrere Knoten verteilen, stellen sie sicher, dass Dienste oder Anwendungen beim Ausfall eines Knotens nahtlos auf einen funktionierenden Knoten wechseln. Ob bei geschäftskritischen Anwendungen, Datenbanken oder Webdiensten: Verfügbarkeit ist unerlässlich, um die Erwartungen der Benutzer:innen zu erfüllen und einen unterbrechungsfreien Betrieb zu gewährleisten.
- Minderung von Ausfallzeiten:
Ausfallzeit kann schwerwiegende Folgen für Unternehmen haben und zu Produktivitäts-, Umsatz- und Kundenzufriedenheitsverlusten führen. Failover-Clustering mindert Ausfallzeiten, indem es schnell auf Hardware- oder Software-Ausfälle reagiert. Der automatisierte Failover-Mechanismus sorgt dafür, dass die Arbeitslast transparent auf einen anderen funktionierenden Knoten verlagert wird. Das hilft beim Ausfall eines Knotens und verkürzt die Zeit bis zur Wiederherstellung der Serververfügbarkeit.
- Daten- und Dienstkontinuität:
Die Kontinuität von Daten und Diensten steht beim Failover-Clustering im Mittelpunkt. Durch redundante Komponenten und Failover-Mechanismen ermöglichen Cluster es Unternehmen, den Zugriff auf kritische Daten und Dienste ohne Unterbrechung aufrechtzuerhalten. Redundanter gemeinsamer Speicher sorgt für konsistente Daten auf allen Knoten. Failover-Mechanismen für Anwendungen und Dienste stellen gleichzeitig sicher, dass Benutzer:innen ihre Aufgaben nahtlos fortsetzen können. Gerade bei unerwarteten Ausfällen ist das entscheidend. Dieses Maß an Kontinuität ist unverzichtbar, um die Datenintegrität zu wahren, Service Level Agreements (SLAs) einzuhalten und eine widerstandsfähige IT-Infrastruktur aufzubauen, die unterschiedlichsten Herausforderungen standhält.
- Ressourcenoptimierung:
Failover-Cluster ermöglichen einen effizienten Ressourceneinsatz, indem sie Arbeitslasten dynamisch nach Zustand und Kapazität der einzelnen Knoten verteilen. Diese Optimierung hilft Unternehmen, das Maximum aus ihren Hardware-Investitionen herauszuholen. Gleichzeitig werden Rechenressourcen immer dort bereitgestellt, wo sie gerade am dringendsten gebraucht werden.
- Einfachere Wartung:
Failover-Cluster erleichtern Wartungsarbeiten, ohne Dienste zu unterbrechen. Cluster unterstützen eine unterbrechungsfreie Systemwartung. Administrator:innen können Knoten für Wartung oder Upgrades offline nehmen, während die übrigen Knoten die Arbeitslast weiter bewältigen.
Arten von Failover-Clustern
Failover-Cluster lassen sich in zwei Hauptarten unterteilen: Shared-Nothing- und Shared-Disk-Cluster. Beide sind jeweils auf bestimmte Anforderungen zugeschnitten. Welche Variante infrage kommt, hängt unter anderem vom konkreten Anwendungsfall ab. Ebenso spielen der Skalierungsbedarf und die Bereitschaft des Unternehmens, Komplexität zu managen, eine Rolle.
- Shared-Nothing-Failover-Cluster
In einem Shared-Nothing-Failover-Cluster arbeiten die einzelnen Knoten unabhängig voneinander, jeder mit eigenen Ressourcen einschließlich lokalem Speicher. Diese Cluster nutzen ein gemeinsames Netzwerk zur Kommunikation. Zwar setzen sie unter Umständen gemeinsamen Speicher für Konfigurationen oder als Witness Disk ein, die Anwendungsdaten werden jedoch nicht direkt geteilt. Shared-Nothing-Cluster werden oft wegen ihrer Einfachheit und des geringeren Risikos eines einzelnen Ausfallpunkts bevorzugt. Allerdings können sie bei der Skalierbarkeit an Grenzen stoßen, und der Netzwerkverkehr kann während eines Failovers ansteigen.
- Shared-Disk-Failover-Cluster
Diese Failover-Cluster stellen ein zentrales Speichersystem bereit, auf das alle Knoten gemeinsam zugreifen, um Anwendungsdaten zu nutzen. Dabei handelt es sich in der Regel um ein Storage Area Network (SAN) oder einen netzgebundenen Speicher (NAS). Ein Shared-Disk-Cluster bietet Skalierbarkeit, da zusätzliche Knoten Rechenleistung und Speicherkapazität erhöhen. Allerdings sind Shared-Disk-Failover-Cluster meist aufwendiger einzurichten. Wegen der gemeinsamen Speicherkonfiguration sind sie zudem komplizierter zu verwalten. Hinzu kommt, dass es zu Ressourcenkonflikten kommen kann, wenn mehrere Knoten auf denselben Speicher zugreifen.
Failover-Cluster in Hyper-V, Windows Server und VMware
Bestimmte Arten von Failover-Clustern sind eng mit verbreiteten Virtualisierungsplattformen verbunden. Beispiele dafür sind Hyper-V (Microsoft) und VMware. Sehen wir uns die verschiedenen Failover-Cluster-Typen im Kontext dieser Plattformen an:
Failover-Cluster-Typen in Hyper-V
Hyper-V-Host-Cluster
In einem Hyper-V-Cluster werden mehrere physische Server (die bereits erwähnten Knoten) zusammengefasst, um virtuelle Maschinen (VMs) gemeinsam zu hosten und zu verwalten. Fällt ein Knoten aus, wechseln die VMs automatisiert per Failover auf einen anderen funktionierenden Knoten im Cluster, sodass die Verfügbarkeit erhalten bleibt.
Vorteile:
- Hochverfügbarkeit für virtualisierte Arbeitslasten.
- Automatisierte VM-Migration beim Ausfall eines Knotens.
Zu beachten:
- Erfordert gemeinsamen Speicher für die VM-Dateien.
Hyper-V-Replikat
Hyper-V-Replikat bietet eine asynchrone Replikation von VMs von einem Hyper-V-Host auf einen anderen. Fällt der primäre Host aus, lässt sich die replizierte VM auf dem sekundären Host aktivieren, was die Ausfallzeit verkürzt.
Vorteile:
- Räumliche Trennung für die Notfallwiederherstellung.
- Asynchrone Replikation für mehr Flexibilität.
Zu beachten:
- Beim Failover ist mit einem gewissen Datenverlust zu rechnen.
Typen des Windows Server Failover Cluster (WSFC)
Failover-Cluster für Dateiserver
Windows Server Failover Cluster (WSFCs) lassen sich so konfigurieren, dass sie Hochverfügbarkeit für Dateiserverdienste bieten. Mehrere Knoten sorgen gemeinsam für den Zugriff auf freigegebene Dateien und Ordner, mit automatisiertem Failover beim Ausfall eines Knotens oder Dienstes.
Vorteile:
- Durchgehender Dateizugriff für Benutzer:innen.
- Automatisierte Wiederherstellung nach Knotenausfällen.
Zu beachten:
- Erfordert gemeinsamen Speicher für die freigegebenen Dateien.
Failover-Cluster für SQL Server
Failover-Cluster lassen sich einsetzen, um Hochverfügbarkeit für SQL-Server-Datenbanken zu erreichen. Mehrere Knoten hosten SQL Server-Instanzen. Fällt einer aus, wechseln die Dienste nahtlos per Failover auf einen anderen Knoten.
Vorteile:
- Durchgehende Verfügbarkeit der SQL-Server-Datenbanken.
- Automatisiertes Failover für minimale Ausfallzeit.
Zu beachten:
- Erfordert gemeinsamen Speicher für die Datenbankdateien.
Failover-Cluster-Typen in VMware
vSphere High Availability (HA)
VMware vSphere HA bietet Hochverfügbarkeit für virtuelle Maschinen in einem vSphere-Cluster. Fällt ein Host aus, werden die VMs automatisiert auf anderen Hosts im Cluster neu gestartet.
Vorteile:
- Automatisierter Neustart der VMs für den fortlaufenden Betrieb.
- Kein gemeinsamer Speicher erforderlich.
Zu beachten:
- Während des Failovers kann es zu einer kurzen VM-Ausfallzeit kommen.
Fault Tolerance (FT)
VMware FT sorgt für durchgehende Verfügbarkeit, indem eine zweite Kopie einer VM auf einem anderen Host vorgehalten wird. Fällt der primäre Host aus, übernimmt die sekundäre VM ohne Unterbrechung.
Vorteile:
Keine Ausfallzeit bei Host-Ausfällen.
Durchgehender Schutz auf VM-Ebene.
Zu beachten:
Erfordert gemeinsamen Speicher und spezielle Hardware-Unterstützung.
Varianten hybrider Cluster
Diese Konfigurationen kombinieren Elemente verschiedener Technologien oder Plattformen, um bestimmte Ziele zu erreichen. Zwei Beispiele für hybride Cluster sind Failover-Cluster für SQL Server und Red-Hat-Linux-Cluster. Beide sehen wir uns im Folgenden an:
Failover-Cluster für SQL Server
Ein Failover-Cluster für SQL Server ist eine hybride Cluster-Konfiguration, die Microsoft SQL Server mit Windows Server Failover Clustering kombiniert. Dabei hosten mehrere Knoten SQL-Server-Instanzen, und der Failover-Cluster sorgt für eine hohe Datenbankverfügbarkeit.
Vorteile:
- Durchgehende Verfügbarkeit der SQL-Server-Datenbanken.
- Automatisiertes Failover bei Knoten- oder Dienstausfällen.
- Nutzt Windows Server Failover Clustering für mehr Zuverlässigkeit.
Zu beachten:
- Erfordert gemeinsamen Speicher für die Datenbankdateien.
- Die Funktionen von Windows Server Failover Clustering sind fester Bestandteil der Failover-Fähigkeiten von SQL Server.
Red-Hat-Linux-Cluster
Red-Hat-Linux-Cluster werden häufig mit Technologien wie Pacemaker und Corosync aufgebaut. So entstehen hochverfügbare Konfigurationen für Anwendungen und Dienste auf Linux-Systemen. Diese Cluster können hybrid sein, und zwar in dem Sinne, dass sie sich mit Speicherlösungen verschiedener Anbieter, Virtualisierungstechnologien oder Cloud-Diensten verbinden lassen.
Vorteile:
- Hochverfügbarkeit für Linux-basierte Anwendungen und Dienste.
- Flexible Integration mit unterschiedlichen Speicher- und Virtualisierungstechnologien.
- Geeignet für On-Premises- oder cloudbasierte Bereitstellungen.
Zu beachten:
- Erfordert Kenntnisse und die Konfiguration von Linux-Clustering-Technologien.
- Hybride Ansätze bringen gegebenenfalls Kompatibilitätsfragen mit Drittanbieterlösungen mit sich.
- Diese hybriden Cluster-Varianten zeigen, wie flexibel und anpassungsfähig Clustering-Technologien sind, um plattformübergreifend spezifische Anforderungen zu erfüllen.
So funktionieren Failover-Cluster
Failover-Cluster beruhen auf einer Gruppe miteinander verbundener Server, den sogenannten Knoten. Sie arbeiten zusammen, um Hochverfügbarkeit und den fortlaufenden Betrieb von Diensten oder Anwendungen sicherzustellen. Das Hauptziel besteht darin, Hardware- oder Software-Ausfälle zu erkennen und darauf zu reagieren. Letztlich geht es darum, Ausfallzeiten zu minimieren und die Dienstkontinuität zu wahren. Der Mechanismus umfasst diese zentralen Schritte:
- Cluster-Bildung
Mehrere Knoten werden mit einem gemeinsamen Netzwerk verbunden und bilden so einen Cluster. Je nach Cluster-Typ kann der Cluster gemeinsamen Speicher oder andere gemeinsame Ressourcen nutzen, wie im vorherigen Abschnitt beschrieben.
- Zustandsüberwachung
Die Cluster-Management-Software überwacht fortlaufend Zustand und Status jedes Knotens im Cluster. Dazu gehört die Prüfung auf Hardware-Ausfälle, Netzwerkverbindungen und die Verfügbarkeit kritischer Dienste.
- Heartbeat-Kommunikation
Die Knoten kommunizieren über ein Verfahren, das Heartbeat-Kommunikation.genannt wird. Heartbeats sind Signale, die die Knoten in regelmäßigen Abständen austauschen, um Zustand und Verfügbarkeit des jeweils anderen zu bestätigen. Sendet ein Knoten keine Heartbeats mehr oder gilt er aus anderen Gründen als gestört, erkennt die Cluster-Management-Software ihn als möglicherweise problematisch.
- Ressourcenzuständigkeit und Failover-Richtlinien
Jeder Knoten im Cluster kann die Dienste oder Anwendungen hosten und verwalten. Failover-Richtlinien und Regeln zur Ressourcenzuständigkeit legen fest, welcher Knoten zu einem bestimmten Zeitpunkt für welche Dienste verantwortlich ist. Diese Richtlinien stellen sicher, dass ein anderer funktionierender Knoten die Arbeitslast übernehmen kann, wenn ein Knoten ausfällt.
- Automatisiertes Failover
Bei einem Ausfall löst die Cluster-Management-Software einen automatisierten Failover-Prozess aus. Dabei wechseln Dienste oder Anwendungen vom ausgefallenen auf einen funktionierenden Knoten im Cluster. Dieser Vorgang läuft für Benutzer:innen in der Regel unbemerkt ab und hält die Beeinträchtigung gering.
- Gemeinsamer Speicher (optional)
In manchen Failover-Clustern dient gemeinsamer Speicher dazu, Anwendungsdaten oder Konfigurationen abzulegen. Gemeinsamer Speicher ermöglicht einen konsistenten Datenzugriff über alle Knoten hinweg und erleichtert ein nahtloses Failover.
- Manueller Eingriff (optional)
In bestimmten Situationen müssen Administrator:innen manuell eingreifen, insbesondere bei geplanten Wartungsarbeiten oder bei speziellen Problemen. Manuelle Eingriffe stellen sicher, dass der Failover-Prozess zu den Anforderungen und Richtlinien des Unternehmens passt.
- Wiederherstellung und Redundanz
Nach dem Failover läuft der Cluster mit den verbliebenen funktionierenden Knoten weiter. Sobald der ausgefallene Knoten wiederhergestellt oder ein Ersatz in Betrieb genommen ist, kann der Cluster seine Ressourcen neu verteilen. Alternativ kehrt er zu seiner ursprünglichen Konfiguration zurück.
Mit diesen Schritten bieten Failover-Cluster eine robuste Lösung, um Hochverfügbarkeit zu sichern und Ausfallzeiten in kritischen IT-Umgebungen zu minimieren.
Einsatzgebiete von Failover-Clustering
Failover-Cluster kommen in den unterschiedlichsten Branchen zum Einsatz und bieten robuste Lösungen für Geschäftskontinuität, Notfallwiederherstellung, Skalierbarkeit und Lastverteilung. Diese Praxisbeispiele zeigen ihre Vielseitigkeit:
Finanzwesen: Business Continuity und Notfallwiederherstellung (BCDR)
Banken und Finanzinstitute setzen Failover-Cluster ein, um die durchgehende Verfügbarkeit kritischer Dienste sicherzustellen. Dazu zählen Online-Banking und Transaktionsverarbeitung. Fällt ein Server aus, garantieren Failover-Mechanismen einen unterbrechungsfreien Dienst und verhindern finanzielle Beeinträchtigungen für Kund:innen.
E-Commerce-Plattformen: maximale Betriebszeit
Online-Händler nutzen Failover-Cluster, damit ihre E-Commerce-Websites erreichbar bleiben. Das gilt besonders in Zeiten mit hohem Traffic oder bei Serverausfällen. Diese durchgehende Verfügbarkeit ist entscheidend für Kundenzufriedenheit und Umsatz.
Cloud-Anbieter: Skalierbarkeit und Lastverteilung
Cloud-Anbieter nutzen Failover-Cluster, um ihre Dienste dynamisch zu skalieren. Steigt die Nachfrage, lassen sich neue Knoten in den Cluster aufnehmen, um Arbeitslasten effizient zu verteilen. Mechanismen zur Lastverteilung sorgen für eine optimale Ressourcennutzung und damit für zuverlässige, skalierbare Cloud-Dienste.
Content Delivery Networks (CDNs): Tempo und Effizienz
CDNs setzen Failover-Cluster ein, um Inhalte schnell und zuverlässig auszuliefern. Knoten weltweit können Benutzeranfragen bearbeiten. Der Failover-Prozess leitet den Traffic nahtlos auf funktionierende Knoten um, verhindert Dienstunterbrechungen und optimiert die Auslieferung der Inhalte.
Telekommunikationsnetze: zuverlässige Konnektivität
Telekommunikationsunternehmen setzen Failover-Cluster in ihren Netzen für Sprach- und Datendienste ein. Bei Netzüberlastung sorgt das Failover dafür, dass Kommunikationsdienste auf alternative Knoten umgeleitet werden und die Verbindung für die Benutzer:innen bestehen bleibt.
Fertigung: Planung der Notfallwiederherstellung
Fertigungsbetriebe nutzen Failover-Cluster, um die Kontinuität von Produktions- und Lieferkettensystemen sicherzustellen. Bei einem Serverausfall garantiert das Failover, dass Fertigungsprozesse und Auftragsabwicklung unbeeinträchtigt bleiben und Störungen minimal ausfallen.
Behörden und öffentliche Dienste: Handlungsfähigkeit des Staates
Behörden setzen Failover-Cluster für zentrale öffentliche Dienste ein, etwa für die Steuerverarbeitung oder Notfallsysteme. Die Failover-Fähigkeit sorgt dafür, dass wesentliche staatliche Funktionen selbst bei unerwarteten Ereignissen oder Katastrophen weiterlaufen.
Sie möchten die Betriebszeit Ihrer Systeme erhöhen? Sehen Sie sich Was ist ein Failover-Cluster? Funktionsweise und Einsatzgebiete an.
Vermeiden Sie teure Ausfallzeiten und sichern Sie Ihre Geschäftskontinuität mit NinjaOne.
→ Testen Sie NinjaOne Backup oder sehen Sie sich eine Demo an.
Die Wirkung von Failover-Clustering
Wie Sie gesehen haben, ist Failover-Clustering entscheidend für den unterbrechungsfreien Betrieb. Das gilt besonders für kritische IT-Systeme in ganz unterschiedlichen Branchen. Diese robuste Technologie, wie die Praxisbeispiele zeigen, ist unverzichtbar für Geschäftskontinuität, Notfallwiederherstellung, Skalierbarkeit und Lastverteilung.
Die Bedeutung von Failover-Clustering in der IT liegt darin, Hochverfügbarkeit aufrechtzuerhalten. Es optimiert außerdem die Ressourcennutzung und trägt erheblich zur Widerstandsfähigkeit und Effizienz von Unternehmen in einer sich ständig wandelnden Technologielandschaft bei.
Wenn Sie eine robuste IT-Infrastruktur aufbauen möchten, lohnt es sich, Failover-Clustering näher zu betrachten.






