
Punti chiave
- Definizione e scopo del failover cluster: un failover cluster è un gruppo di server (nodi) che trasferisce automaticamente i carichi di lavoro in caso di guasto, per garantire alta disponibilità, tempi di inattività minimi e continuità operativa.
- Componenti principali e prerequisiti: richiede più nodi, un software di gestione del cluster, una rete affidabile e spesso uno storage condiviso per rilevare i guasti e attivare un failover senza interruzioni.
- Come funziona il failover clustering (passaggi): il cluster monitora costantemente lo stato dei nodi → rileva il guasto → sposta automaticamente servizi e applicazioni su un nodo integro → ripristina le operazioni con il minimo disagio per il servizio.
- Tipi e configurazioni di failover cluster: i modelli più diffusi includono i cluster active-active e active-passive, oltre alle architetture shared-disk e shared-nothing, ognuna con un impatto diverso su prestazioni, costi e complessità.
- Best practice per failover cluster affidabili: elimina i single point of failure, testa regolarmente il failover, mantieni configurazioni coerenti tra i nodi e monitora le prestazioni per garantire resilienza, scalabilità e operatività.
La continuità operativa e la resilienza dei sistemi sono aspetti critici dell’IT aziendale moderno. La tecnologia failover cluster può svolgere un ruolo decisivo nel raggiungimento di questi obiettivi. Questo articolo approfondisce il cuore dei failover cluster, analizzandone il funzionamento e le applicazioni. Che tu sia un professionista IT esperto o un semplice appassionato, continua a leggere. Vedremo come comprendere la complessità dei failover cluster, come funzionano e in quali scenari si rivelano indispensabili.
Che cos’è un failover cluster?
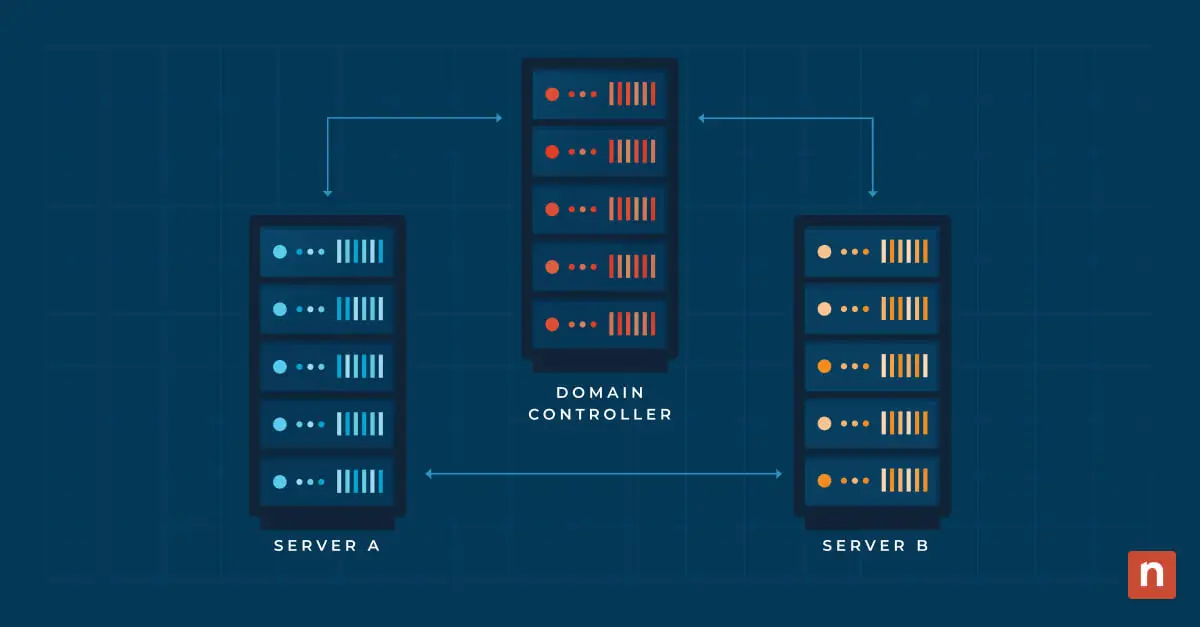
Un failover cluster è una forma specializzata di infrastruttura ad alta disponibilità. È progettato per garantire un funzionamento ininterrotto in caso di guasti hardware o software. In sostanza, si tratta di un gruppo di computer interconnessi che lavorano insieme come un unico sistema. L’obiettivo è fornire ridondanza e disponibilità continua. Lo scopo principale di un failover cluster è rilevare i guasti in un componente del sistema. Il carico di lavoro viene poi trasferito automaticamente a un componente funzionante, senza interruzioni percepibili per gli utenti.
I componenti chiave di un failover cluster comprendono in genere più server (o nodi), risorse di storage condivise e un software di gestione del cluster. Il software di gestione del cluster monitora lo stato e l’integrità dei nodi. Quando viene rilevato un guasto (ad esempio un malfunzionamento hardware), il software di gestione del cluster coordina il processo di failover. Questo comporta lo spostamento del carico di lavoro e delle responsabilità dal nodo in avaria a uno integro. L’obiettivo finale è fare in modo che i servizi o le applicazioni restino accessibili e operativi.
Rafforza la resilienza operativa con gli strumenti di disaster recovery di NinjaOne.
Failover clustering ad alta disponibilità e a disponibilità continua
L’alta disponibilità indica la capacità di un sistema o di un servizio di ridurre al minimo i tempi di inattività grazie a un rapido ripristino dopo un guasto. I failover cluster ad alta disponibilità dispongono in genere degli strumenti per rilevare un guasto, avviare automaticamente un processo di failover e riprendere le operazioni su un nodo di standby. L’obiettivo è ridurre al minimo i tempi di inattività. In questo modo i servizi vengono ripristinati rapidamente, senza causare interruzioni significative.
I failover cluster a disponibilità continua sono leggermente diversi, perché puntano a mantenere il servizio ininterrotto con tempi di inattività minimi o nulli. La disponibilità continua prevede un passaggio fluido dei servizi da un nodo guasto a uno integro, in modo che gli utenti finali non percepiscano alcuna interruzione. Questo richiede in genere una replica sincrona dei dati verso il nodo di standby.
Sicurezza e protezione grazie alla ridondanza
La ridondanza è un concetto fondamentale nell’ambito del failover clustering. Indica l’inserimento di componenti o sistemi duplicati all’interno di un cluster per garantire affidabilità e tolleranza ai guasti. L’obiettivo principale della ridondanza è eliminare i single point of failure, cioè i punti deboli di un sistema che, se compromessi, potrebbero causare interruzioni di servizio o perdite di dati. Nel contesto del failover clustering, la ridondanza svolge un ruolo cruciale: aiuta a mantenere le operazioni continue anche quando uno o più componenti subiscono un guasto.
In un failover cluster la ridondanza viene implementata in vari modi:
- Ridondanza dei nodi: i failover cluster sono composti da più nodi, ovvero singoli server, che lavorano insieme come un sistema unificato. Se un nodo si guasta per problemi hardware o software, i nodi restanti del cluster si fanno carico del carico di lavoro per evitare tempi di inattività. In questo modo, anche se un server diventa indisponibile, i servizi o le applicazioni possono passare senza interruzioni a un altro nodo funzionante.
- Ridondanza dello storage condiviso: i cluster utilizzano spesso risorse di storage condivise, come le Storage Area Network (SAN), per mantenere dati coerenti su tutti i nodi. La ridondanza nello storage condiviso si ottiene con tecnologie come il RAID (Redundant Array of Independent Disks), che proteggono dai guasti dei dischi. In questo modo, anche se un dispositivo di storage si guasta, i dati restano accessibili grazie ai meccanismi di storage ridondanti. Per approfondire questi concetti, comprese indicazioni pratiche su come vengono implementate le SAN e sui vantaggi che offrono, dai un’occhiata a Che cos’è una Storage Area Network (SAN)? Vantaggi e implementazione.
- Ridondanza di rete: la comunicazione tra i nodi del cluster è essenziale per il coordinamento e la sincronizzazione dei dati. La ridondanza di rete prevede più percorsi e interfacce di rete, così che il cluster possa continuare a comunicare attraverso percorsi alternativi se una connessione di rete viene a mancare. Questo aiuta a evitare l’isolamento dei nodi e garantisce la disponibilità continua.
- Ridondanza di alimentazione e hardware: alimentatori ridondanti, sistemi di raffreddamento e altri componenti hardware contribuiscono all’affidabilità complessiva del failover cluster. Queste misure proteggono dai guasti causati da interruzioni di corrente o malfunzionamenti hardware.
Perché il failover clustering è importante
Il failover clustering è un elemento fondamentale dell’infrastruttura IT moderna, perché risponde ad aspetti critici come l’alta disponibilità e l’accessibilità continua a dati e servizi. Vediamone nel dettaglio il valore:
- Disponibilità:
l’alta disponibilità è cruciale per sistemi e applicazioni che devono essere accessibili in ogni momento. Distribuendo i carichi di lavoro su più nodi, i failover cluster fanno sì che, se un nodo subisce un guasto, i servizi o le applicazioni passino senza interruzioni a un nodo integro. Che si tratti di applicazioni business-critical, database o servizi web, mantenere la disponibilità è essenziale per soddisfare le aspettative degli utenti e garantire operazioni ininterrotte.
- Riduzione dei tempi di inattività:
i tempi di inattività possono avere conseguenze gravi per le aziende, con perdita di produttività, di fatturato e di soddisfazione dei clienti. Il failover clustering riduce i tempi di inattività rispondendo rapidamente ai guasti hardware o software. Il meccanismo di failover automatico fa sì che il carico di lavoro venga spostato in modo trasparente su un altro nodo funzionante. Questo è utile in caso di guasto di un nodo, perché riduce al minimo il tempo necessario per ripristinare la disponibilità del server.
- Continuità di dati e servizi:
la continuità di dati e servizi è uno degli obiettivi centrali del failover clustering. Grazie a componenti ridondanti e meccanismi di failover, i cluster consentono alle organizzazioni di mantenere un accesso ininterrotto a dati e servizi critici. La ridondanza dello storage condiviso garantisce la coerenza dei dati tra i nodi. Allo stesso tempo, i meccanismi di failover per applicazioni e servizi assicurano che gli utenti possano continuare a lavorare senza interruzioni. È un aspetto cruciale di fronte a guasti imprevisti. Questo livello di continuità è essenziale per preservare l’integrità dei dati, rispettare gli accordi sui livelli di servizio (SLA) e costruire un’infrastruttura IT resiliente, in grado di affrontare sfide di ogni tipo.
- Ottimizzazione delle risorse:
i failover cluster permettono di usare le risorse in modo efficiente, assegnando dinamicamente i carichi di lavoro in base allo stato e alla capacità di ciascun nodo. Questa ottimizzazione aiuta le organizzazioni a sfruttare al massimo gli investimenti in hardware, garantendo al tempo stesso che le risorse di calcolo vengano assegnate dove servono di più in ogni momento.
- Manutenzione semplificata:
i failover cluster agevolano le attività di manutenzione senza causare interruzioni ai servizi. I cluster supportano un approccio alla manutenzione dei sistemi privo di interruzioni, perché consentono agli amministratori di mettere offline i nodi per manutenzione o aggiornamenti mentre i nodi restanti continuano a gestire il carico di lavoro.
Tipi di failover cluster
I failover cluster si dividono in due tipologie principali: shared-nothing e shared-disk. Ciascuna risponde a esigenze specifiche. La scelta tra questi tipi di cluster dipende da fattori come la specifica situazione d’uso. Può dipendere anche dalle esigenze di scalabilità e dalla disponibilità dell’organizzazione a gestire una maggiore complessità.
- Failover cluster shared-nothing
In un failover cluster shared-nothing i singoli nodi operano in modo indipendente, ciascuno con il proprio insieme dedicato di risorse, incluso lo storage locale. Questi cluster utilizzano una rete comune per la comunicazione. Possono impiegare uno storage condiviso per la configurazione o come witness disk, ma i dati delle applicazioni non vengono condivisi direttamente. I cluster shared-nothing sono spesso preferiti per la loro semplicità e per il minor rischio di single point of failure. Possono però presentare limiti in termini di scalabilità e un possibile aumento del traffico di rete durante i failover.
- Failover cluster shared-disk
Questi failover cluster prevedono un sistema di storage centralizzato, in cui tutti i nodi condividono l’accesso ai dati delle applicazioni. Si tratta in genere di una Storage Area Network (SAN) o di un NAS (Network Attached Storage). Un cluster shared-disk offre scalabilità, perché l’aggiunta di nodi consente di aumentare potenza di elaborazione e capacità di storage. I failover cluster shared-disk tendono però a essere più complessi da configurare. Sono anche più complicati da gestire, a causa delle configurazioni di storage condiviso. Possono inoltre sorgere problemi di contesa delle risorse, dato che più nodi accedono allo stesso storage.
Failover cluster con Hyper-V, Windows Server e VMware
Alcuni tipi di failover cluster sono legati a piattaforme di virtualizzazione molto diffuse, come Hyper-V (Microsoft) e VMware. Vediamo i diversi tipi di failover cluster nel contesto di queste piattaforme:
Tipi di failover cluster Hyper-V
Cluster di host Hyper-V
In un cluster Hyper-V più server fisici (i nodi di cui sopra) vengono messi in cluster per ospitare e gestire collettivamente le virtual machine (VM). Se un nodo si guasta, le VM eseguono automaticamente il failover su un altro nodo integro del cluster, garantendo la disponibilità continua.
Vantaggi:
- Alta disponibilità per i carichi di lavoro virtualizzati.
- Migrazione automatica delle VM in caso di guasto di un nodo.
Aspetti da considerare:
- Richiede uno storage condiviso per i file delle VM.
Hyper-V Replica
Hyper-V Replica offre la replica asincrona delle VM da un host Hyper-V a un altro. In caso di guasto dell’host primario, la VM replicata può essere attivata sull’host secondario, riducendo al minimo i tempi di inattività.
Vantaggi:
- Separazione geografica per il disaster recovery.
- Replica asincrona per maggiore flessibilità.
Aspetti da considerare:
- Comporta una certa perdita di dati in caso di failover.
Tipi di Windows Server Failover Cluster (WSFC)
Failover cluster per file server
I Windows Server Failover Cluster (WSFC) possono essere configurati per garantire l’alta disponibilità dei servizi di file server. Più nodi lavorano insieme per assicurare l’accesso a file e cartelle condivisi, con failover automatico in caso di guasto di un nodo o di un servizio.
Vantaggi:
- Accesso continuo ai file per gli utenti.
- Ripristino automatico dai guasti dei nodi.
Aspetti da considerare:
- Richiede uno storage condiviso per i file condivisi.
Failover cluster per SQL Server
I failover cluster possono essere implementati per garantire l’alta disponibilità dei database SQL Server. Più nodi ospitano istanze di SQL Server e, in caso di guasto, i servizi passano senza interruzioni a un altro nodo.
Vantaggi:
- Disponibilità continua dei database SQL Server.
- Failover automatico per ridurre al minimo i tempi di inattività.
Aspetti da considerare:
- Richiede uno storage condiviso per i file di database.
Tipi di failover cluster VMware
vSphere High Availability (HA)
VMware vSphere HA garantisce l’alta disponibilità delle virtual machine in un cluster vSphere. Se un host si guasta, le VM vengono riavviate automaticamente su altri host all’interno del servizio cluster.
Vantaggi:
- Riavvio automatico delle VM per garantire la continuità operativa.
- Nessuna necessità di storage condiviso.
Aspetti da considerare:
- Può comportare un breve tempo di inattività delle VM durante il failover.
Fault Tolerance (FT)
VMware FT garantisce la disponibilità continua mantenendo una copia secondaria di una VM su un altro host. Se l’host primario si guasta, la VM secondaria subentra senza interruzioni.
Vantaggi:
Zero tempi di inattività in caso di guasto dell’host.
Protezione continua a livello di VM.
Aspetti da considerare:
Richiede storage condiviso e un supporto hardware specifico.
Varianti di cluster ibridi
Queste configurazioni combinano elementi di tecnologie o piattaforme diverse per raggiungere obiettivi specifici. Due esempi di cluster ibridi sono i failover cluster per SQL Server e i cluster Red Hat Linux. Li vediamo qui di seguito:
Failover cluster per SQL Server
Un failover cluster per SQL Server è una configurazione di cluster ibrida che combina SQL Server di Microsoft con il Windows Server Failover Clustering. In questo scenario più nodi ospitano istanze di SQL Server e il failover cluster garantisce l’alta disponibilità del database.
Vantaggi:
- Disponibilità continua dei database SQL Server.
- Failover automatico in caso di guasto di un nodo o di un servizio.
- Sfrutta il Windows Server Failover Clustering per garantire affidabilità.
Aspetti da considerare:
- Richiede uno storage condiviso per i file di database.
- Le funzionalità del Windows Server Failover Clustering sono parte integrante delle capacità di failover di SQL Server.
Cluster Red Hat Linux
I cluster Red Hat Linux vengono spesso realizzati con tecnologie come Pacemaker e Corosync. Questo permette di creare configurazioni ad alta disponibilità per applicazioni e servizi su sistemi basati su Linux. Questi cluster possono essere ibridi, nel senso che possono integrarsi con soluzioni di storage di fornitori diversi, tecnologie di virtualizzazione o servizi cloud.
Vantaggi:
- Alta disponibilità per applicazioni e servizi basati su Linux.
- Flessibilità di integrazione con diverse tecnologie di storage e virtualizzazione.
- Adatti a distribuzioni on-premises o nel cloud.
Aspetti da considerare:
- Richiedono la conoscenza e la configurazione delle tecnologie di clustering per Linux.
- Gli aspetti ibridi possono comportare valutazioni di compatibilità con soluzioni di terze parti.
- Queste varianti di cluster ibridi mostrano la flessibilità e l’adattabilità delle tecnologie di clustering nel rispondere a esigenze specifiche su piattaforme diverse.
Come funzionano i failover cluster
I failover cluster funzionano creando un gruppo di server interconnessi, chiamati nodi. Questi collaborano per garantire l’alta disponibilità e il funzionamento continuo di servizi o applicazioni. L’obiettivo principale è rilevare i guasti hardware o software e reagire di conseguenza, riducendo al minimo i tempi di inattività e mantenendo la continuità del servizio. Il meccanismo prevede i seguenti passaggi chiave:
- Formazione del cluster
Più nodi vengono collegati a una rete condivisa, creando un cluster. Il cluster può utilizzare storage condiviso o altre risorse condivise, a seconda del tipo di cluster, come descritto nella sezione precedente.
- Monitoraggio dello stato
Il software di gestione del cluster monitora in modo continuo lo stato e l’integrità di ogni nodo del cluster. Il monitoraggio comprende la verifica di guasti hardware, connettività di rete e disponibilità dei servizi critici.
- Comunicazione tramite heartbeat
I nodi comunicano tra loro attraverso un processo chiamato comunicazione heartbeat.Gli heartbeat sono segnali scambiati tra i nodi a intervalli regolari per confermare l’integrità e la disponibilità di ciascun nodo. Se un nodo smette di inviare heartbeat o viene comunque considerato non integro, il software di gestione del cluster lo identifica come potenzialmente problematico.
- Proprietà delle risorse e criteri di failover
Ogni nodo del cluster è in grado di ospitare e gestire i servizi o le applicazioni. I criteri di failover e le regole di proprietà delle risorse stabiliscono quale nodo è responsabile di specifici servizi in un dato momento. Questi criteri garantiscono che un altro nodo integro possa farsi carico del carico di lavoro in caso di guasto di un nodo.
- Failover automatico
In caso di guasto, il software di gestione del cluster avvia un processo di failover automatico. Il failover prevede il trasferimento dei servizi o delle applicazioni dal nodo guasto a un nodo integro all’interno del cluster. Questo processo è in genere trasparente per gli utenti e garantisce il minimo disagio.
- Storage condiviso (opzionale)
In alcuni failover cluster lo storage condiviso viene utilizzato per archiviare i dati o le configurazioni delle applicazioni. Lo storage condiviso consente un accesso coerente ai dati tra i nodi e facilita un failover senza interruzioni.
- Intervento manuale (opzionale)
In alcuni scenari può essere necessario un intervento manuale degli amministratori, soprattutto durante le attività di manutenzione pianificata o nella gestione di problemi specifici. Gli interventi manuali garantiscono che il processo di failover sia allineato ai requisiti e ai criteri dell’organizzazione.
- Ripristino e ridondanza
Dopo il failover, il cluster continua a funzionare con i nodi integri rimanenti. Una volta ripristinato il nodo guasto o messo online un nodo sostitutivo, il cluster può ribilanciare le proprie risorse. Oppure può tornare alla configurazione originale.
Seguendo questi passaggi, i failover cluster offrono una soluzione solida per mantenere l’alta disponibilità e ridurre al minimo i tempi di inattività negli ambienti di elaborazione critici.
Applicazioni del failover clustering
I failover cluster trovano applicazione in settori molto diversi e offrono soluzioni solide per garantire continuità operativa, disaster recovery, scalabilità e bilanciamento del carico. Questi esempi concreti ne illustrano la versatilità:
Finanza: continuità operativa e disaster recovery (BCDR)
Banche e istituti finanziari utilizzano i failover cluster per garantire la disponibilità continua dei servizi critici, tra cui l’online banking e l’elaborazione delle transazioni. In caso di guasto di un server, i meccanismi di failover assicurano un servizio ininterrotto, evitando disagi finanziari ai clienti.
Piattaforme di e-commerce: massima operatività
I rivenditori online sfruttano i failover cluster per mantenere operativi i propri siti di e-commerce. In particolare nei periodi di traffico intenso o in caso di guasti ai server. Questa disponibilità continua è cruciale per mantenere alta la soddisfazione dei clienti e il fatturato.
Provider cloud: scalabilità e bilanciamento del carico
I provider cloud utilizzano i failover cluster per scalare i propri servizi in modo dinamico. Quando la domanda aumenta, è possibile aggiungere nuovi nodi al cluster per gestire il carico di lavoro in modo efficiente. I meccanismi di bilanciamento del carico garantiscono un utilizzo ottimale delle risorse, offrendo ai clienti servizi cloud affidabili e scalabili.
Content delivery network (CDN): velocità ed efficienza
Le CDN impiegano i failover cluster per garantire una distribuzione dei contenuti rapida e affidabile. I nodi distribuiti in tutto il mondo possono gestire le richieste degli utenti. Il processo di failover reindirizza il traffico senza interruzioni verso i nodi integri, evitando interruzioni di servizio e ottimizzando la distribuzione dei contenuti.
Reti di telecomunicazione: connettività affidabile
Le aziende di telecomunicazioni utilizzano i failover cluster nelle proprie reti per gestire i servizi voce e dati. In caso di congestione della rete, il failover fa sì che i servizi di comunicazione vengano instradati su nodi alternativi, mantenendo la connettività per gli utenti.
Manifattura: pianificazione del disaster recovery
Gli impianti produttivi utilizzano i failover cluster per garantire la continuità dei sistemi di produzione e della catena di fornitura. In caso di guasto di un server, il failover assicura che i processi produttivi e l’evasione degli ordini non ne risentano, riducendo al minimo i disagi.
Pubblica amministrazione e servizi pubblici: continuità dell’azione di governo
Le pubbliche amministrazioni utilizzano i failover cluster per servizi pubblici essenziali, come l’elaborazione delle imposte o i sistemi di risposta alle emergenze. La capacità di failover garantisce che le funzioni pubbliche essenziali continuino a operare, anche durante eventi imprevisti o disastri.
Vuoi migliorare l’operatività dei tuoi sistemi? Guarda che cos’è un failover cluster? Come funziona e quali sono le sue applicazioni.
Riduci i costosi tempi di inattività e garantisci la continuità operativa con NinjaOne.
→ Prova NinjaOne Backup oppure guarda una demo.
L’impatto del failover clustering
Come hai visto, il failover clustering è determinante per garantire la continuità operativa, in particolare dei sistemi IT critici nei settori più diversi. Questa tecnologia solida, come dimostrano le applicazioni concrete, è essenziale per la continuità operativa, il disaster recovery, la scalabilità e il bilanciamento del carico.
L’importanza del failover clustering nell’IT sta nella sua capacità di mantenere l’alta disponibilità. Ottimizza inoltre l’utilizzo delle risorse e contribuisce in modo significativo alla resilienza e all’efficienza delle organizzazioni in un panorama tecnologico in continua evoluzione.
Se vuoi costruire un’infrastruttura IT solida, ti invitiamo ad approfondire ulteriormente il failover clustering.






