


De financiële en operationele gevolgen van uitvaltijd zijn de afgelopen zeven jaar steeds zwaarder geworden. In 2014 voorspelde Gartner dat uitvaltijd organisaties gemiddeld 300.000 dollar per uur kost. Recente cijfers steken echter schril af bij die schatting van zes cijfers: 44% van de organisaties becijfert de kosten van uitvaltijd inmiddels op meer dan 1 miljoen dollar per uur – en dan zijn boetes of juridische kosten nog niet meegerekend.
Ook al beloven cloudleveranciers en -partners 99% uptime, de dagelijkse realiteit van zo’n SLA erkent dat uitvaltijd onvermijdelijk is: zelfs bij een perfecte uptime van 99% moeten klanten nog altijd rekening houden met 8 uur frustratie per jaar. De preventieve maatregelen van veel bedrijven vallen onder het motto ‘uit het oog, uit het hart’. Door de realiteit van uitvaltijd te negeren, kunnen de kosten van uitvaltijd echter ongecontroleerd oplopen.
Wat is uitvaltijd?
Uitvaltijd is de periode waarin een systeem, dienst, machine of proces niet beschikbaar is of niet op volle capaciteit werkt. Gebruikers kunnen geen onlinediensten benaderen, de productiviteit van medewerkers loopt sterk terug en klanten kunnen geen contact meer leggen met uw organisatie. Die gevolgen stapelen zich op en groeien uit tot aanzienlijke schade aan de reputatie van een organisatie.
Facebook – inmiddels Meta – telt miljarden gebruikers. Eind 2021 lag bijna elk platform van Meta meer dan 5 uur plat. De storing was het gevolg van een wijziging in de configuratie van verschillende backbone-routers. Deze routers regelen het netwerkverkeer tussen de datacenters van Facebook, waardoor de update een domino-effect veroorzaakte. Volgens Cloudflare liet Facebook in feite aan het Border Gateway Protocol (BGP) weten dat de routes naar WhatsApp, Instagram, Facebook en andere diensten niet langer bruikbaar waren. Wie Facebook probeerde te bereiken, vond daardoor simpelweg geen route meer.
Deze storing maakte niet alleen Facebook onbereikbaar: alle diensten en processen die eraan gekoppeld waren, verdwenen mee. Bovendien stonden niet alleen eindgebruikers buitenspel. De interne systemen van Facebook draaien op dezelfde processen, waardoor medewerkers het probleem moeilijk konden vaststellen en oplossen. Door de storing daalde de aandelenkoers van Facebook met 4,9% en zag CEO Mark Zuckerberg zijn persoonlijke vermogen met 6 miljard dollar slinken.
Veel organisaties kiezen ervoor de realiteit van ongecontroleerde uitvaltijd te negeren, terwijl het juist een cruciale graadmeter is voor de betrouwbaarheid en prestaties van uw bedrijfsprocessen.
Hoe uitvaltijd ontstaat
Niet alle uitvaltijd kost evenveel. Er zijn twee hoofdvormen, die elk een eigen aanpak vragen.
Geplande uitvaltijd
Dit is een geplande onderbreking van processen of diensten voor onderhoud, updates, reparaties of andere geplande werkzaamheden. Doorgaans vindt die plaats buiten piekuren om de verstoring te beperken en krijgen eindgebruikers ruim van tevoren bericht. Geplande uitvaltijd is essentieel om de volgende vormen van uitvaltijd terug te dringen.
Ongeplande uitvaltijd
Ongeplande uitvaltijd treedt onverwacht op, is verstorend en kan tot grote financiële en operationele verliezen leiden.
Ongeplande uitvaltijd is op te splitsen in twee hoofdvormen. De eerste wordt veroorzaakt door menselijke factoren. Volgens een rapport van het Downtime Institute van vorig jaar is menselijke fouten de oorzaak van bijna 40% van alle grote incidenten in de afgelopen drie jaar. Daarvan ontstaat bijna 90% doordat medewerkers protocollen niet volgen of doordat de procedures zelf tekortschieten. Protocollen voor het toewijzen van resources moeten bijvoorbeeld nauwlettend worden gevolgd, want een te lage inschatting van de benodigde resources leidt al snel tot overbelasting en uitval van servers.
Interne bedreigingen kosten jaarlijks miljoenen aan omzet, maar de andere, nog zorgwekkender oorzaak van uitvaltijd komt van buiten. Dat varieert van natuurrampen zoals overstromingen die fysieke datacenters bedreigen tot cyberaanvallen die kleine configuratiefouten tegen u gebruiken. Ransomware is een van de ernstigste bedreigingen in deze categorie, omdat het zelfs veilige back-ups volledig kan versleutelen.
Veelvoorkomende oorzaken van uitvaltijd
Helaas zijn er volop situaties die ongeplande uitvaltijd veroorzaken, zoals:
- Cyberaanvallen en datalekken
- Noodsituaties door omgevingsfactoren
- Defecte apparatuur
- Menselijke fouten
- Netwerkproblemen
- Stroomstoringen
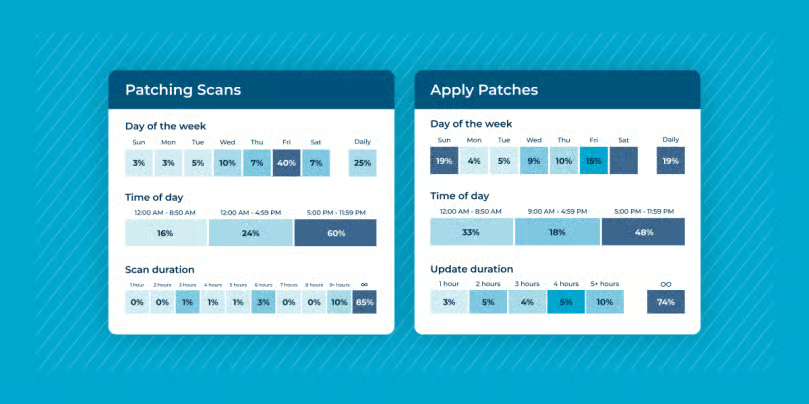
Deze problemen gelden niet voor geplande uitvaltijd, die vaak het gevolg is van Patching, back-ups of andere IT-processen. Bij geplande uitvaltijd brengt een IT-team alle betrokken partijen vooraf op de hoogte.
De kosten van uitvaltijd onder de loep
De formule voor de kosten van uitvaltijd is vrij eenvoudig. De echte cijfers achter elk onderdeel achterhalen is een stuk lastiger. Om tot een werkbare formule te komen, bekijken we elk onderdeel van dichtbij.
Kosten van uitvaltijd = gederfde omzet + verloren productiviteit + herstelkosten
Gederfde omzet
Analyseert u een recente storing, begin dan met vaststellen welke medewerkers getroffen zijn en in welke mate. Sommige medewerkers kunnen doorwerken, zoals technici en engineers op locatie, maar verreweg de meeste operationele systemen vragen tegenwoordig om een permanente internetverbinding. Zelfs in volledig geautomatiseerde productielijnen meten Internet of Things (IoT)-apparaten voortdurend en leveren ze operationele teams realtime efficiëntiegegevens. Zonder die gegevens moeten zelfs offline toeleveringsketens mogelijk worden stilgelegd. Als medewerkers nauwelijks bij onlinesystemen kunnen, kan uw bedrijf bestellingen niet meer even efficiënt afhandelen.
Dit omzetverlies wordt nog ernstiger bij kritieke systemen: e-commerce-winkels die uitsluitend van een online winkel afhankelijk zijn, kunnen helemaal geen omzet meer genereren. Door te analyseren welke sites getroffen zijn en welke rol ze spelen bij het genereren van omzet, kunt u het dagelijkse omzetverlies door een storing nauwkeurig bepalen. Pas dit toe op elk getroffen systeem en tel het totale omzetverlies over alle getroffen systemen bij elkaar op.
Verlies van interne productiviteit
Zolang systemen plat liggen, zitten medewerkers duimen te draaien. De financiële gevolgen daarvan in kaart brengen lijkt in eerste instantie overweldigend. Voor een voorzichtige inschatting van die verloren productiviteit vraagt u uw HR-afdeling om een overzicht van het gemiddelde salaris per getroffen afdeling. Vermenigvuldigt u dat met het aantal medewerkers, dan krijgt u de totale waarde van de verloren loonkosten. Opgeteld bij de gederfde omzet geeft dat een realistisch beeld van het verlies per dag of zelfs per uur.
Herstelkosten
Niet alle medewerkers tellen werkeloos de uren af tot alles weer online is: sommigen werken zich in het zweet om de schade te herstellen en alles weer draaiend te krijgen. De kosten van die werkuren lopen snel op, zeker wanneer IT-teams langer moeten doorwerken. Afhankelijk van de oorzaak van de uitvaltijd zijn er bovendien extra tijd en middelen nodig om alles weer online te krijgen. Of het nu gaat om het wisselen van leverancier of het herstellen van cruciale servers: deze onverwachte ingrepen horen bij de totale kosten te worden meegerekend.
Krijg helder zicht op de gevolgen van uitvaltijd voor uw bedrijf en bekijk deze korte video: ‘Wat zijn de werkelijke kosten van uitvaltijd voor bedrijven?‘
Uitvaltijd beperken en voorkomen
Uitvaltijd is tot op zekere hoogte onvermijdelijk, maar met een goede voorbereiding beperkt u de schade aanzienlijk.
Voer uw disaster recovery-plan uit
De eerste fase bij het opstellen van een disaster recovery-plan (DRP) bestaat uit het inventariseren en beoordelen van bedreigingen en kwetsbaarheden die uw systeembeheer kunnen raken. Denk aan defecte hardware, stroomstoringen, cyberaanvallen, brand, overstromingen, aardbevingen en vergelijkbare gebeurtenissen. Daarnaast is het cruciaal om de RTO (Recovery Time Objective) en de RPO (Recovery Point Objective) voor kritieke systemen en gegevens vast te leggen. De RTO staat voor de maximaal aanvaardbare uitvaltijd van uw systeem, terwijl de RPO aangeeft hoeveel gegevensverlies maximaal toelaatbaar is. Het verschil tussen RTO en RPO begrijpen is essentieel, want deze cijfers bepalen in hoge mate welke herstelwerkzaamheden voorrang krijgen en welke back-up- en herstelstrategie het beste past.
Zijn deze cijfers eenmaal vastgelegd, dan moeten rollen en verantwoordelijkheden worden verdeeld binnen uw team voor systeembeheer en onder andere betrokkenen. Leg vast wie verantwoordelijk is voor het starten, uitvoeren en bewaken van het DRP. Bepaal daarnaast wie de communicatie met interne en externe partijen verzorgt, zoals medewerkers, klanten, leveranciers en toezichthouders. Juist bij een disaster recovery-plan is het bovendien essentieel om voor elke rol vervangers en alternatieven aan te wijzen voor het geval de eerste verantwoordelijken zelf getroffen worden.
Investeer in betrouwbare back-upsystemen
Lokale back-ups van gegevens zijn nuttig, maar besef dat u met uitsluitend deze vorm van back-up kwetsbaar blijft voor fysieke bedreigingen zoals brand, overstroming en diefstal. Het belang van back-ups en hun rol bij sneller herstel valt nauwelijks te overschatten. Daarom luidt het advies om minstens drie kopieën van uw gegevens te bewaren, waarvan één buiten uw normale IT-infrastructuur.
Cloudback-up-leveranciers zijn bij uitstek bestand tegen uitvaltijd, dankzij het gemak van opschaling en het gebruik van meerdere instances. Denk aan een Kubernetes-omgeving binnen de cloudinfrastructuur van AWS met twee nodes. Daarin zit een autoscaling-trigger die detecteert wanneer het CPU-gebruik structureel boven 75% blijft en extra pods toevoegt.
Meerdere nodes zorgen er bovendien voor dat uw applicatie blijft draaien, ook als een deel van het cluster uitvalt. Kubernetes probeert pods gelijkmatig over de instances van het cluster te verdelen. Het is echter cruciaal dat extra resources op tijd beschikbaar komen en niet pas wanneer de UX al te lijden heeft.
Monitoring en bescherming
Zoals in het vorige punt al even aangestipt, is endpoint-monitoring een belangrijke pijler van het voorkomen van uitvaltijd. Notificaties geven u niet alleen realtime inzicht in overtreden beleidsregels en conflicten om resources, maar ook een plek op de eerste rij als het om uw algehele beveiliging gaat. Firewalls en blacklists houden aanvallers buiten de deur, terwijl de ingebouwde Web Application Firewall (WAF) van AWS u waarschuwt bij lopende DDoS-aanvallen of pogingen tot SQL-injectie. Die realtime meldingen komen vervolgens binnen op uw e-mail of telefoon, zodat u snel preventief kunt optreden.
De werkelijke kosten van uitvaltijd zijn te hoog
Veerkracht staat centraal bij het terugdringen van de oplopende kosten van uitvaltijd. NinjaOne geeft bedrijfs-IT-diensten een boost door problemen met endpoints proactief op te sporen en een platform te bieden voor automatisch herstel. Bestanden kunnen op verschillende manieren worden teruggezet, van selfservice-bestandsherstel door de eindgebruiker tot herstel via het web. Zo blijft de werkdruk voor technici beperkt op het moment dat ze het hardst nodig zijn. Van ticket tot back-up: Ninja ondersteunt elke laag van bescherming tegen uitvaltijd.