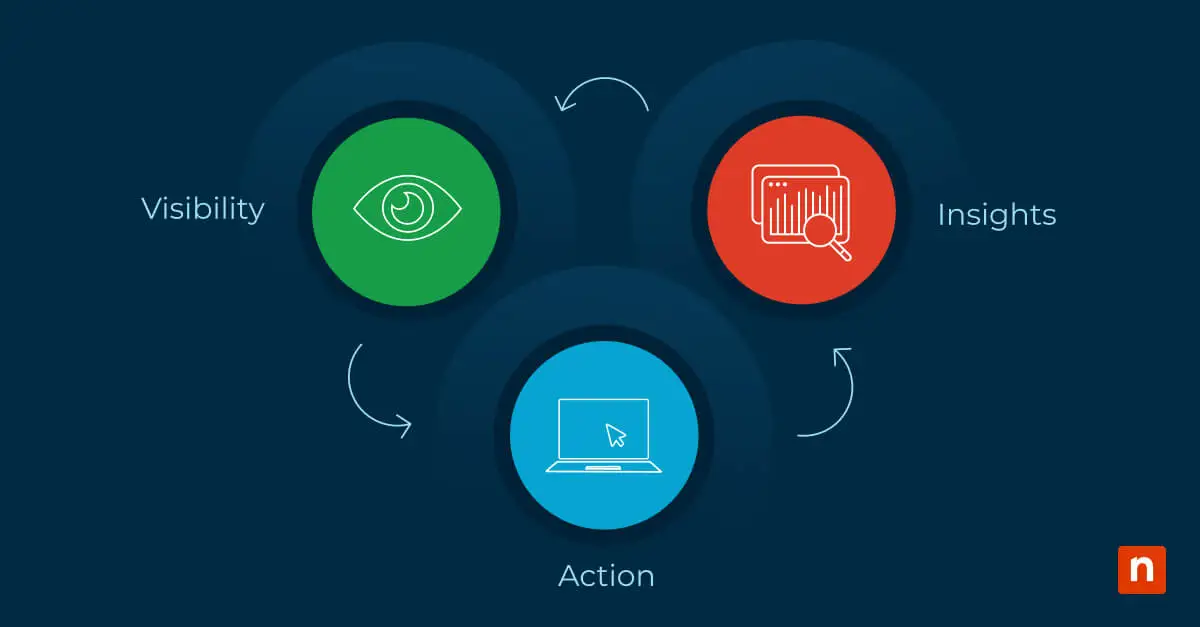
Full stack observability draait niet alleen om het verzamelen van data maar om het leveren van bruikbare inzichten. U kijkt verder dan losse metrics en logs en krijgt een dieper begrip van de onderlinge samenhang van moderne softwaresystemen. Met full stack observability bewaakt u de operationele integriteit, pakt u prestatieproblemen snel aan en zorgt u voor een naadloze UX.
Wat is full stack observability?
Full stack observability is het volledig monitoren, volgen en analyseren van uw complete applicatiestack, van de front-end gebruikersinterface tot de back-end infrastructuur. Het omvat verschillende tools en praktijken die u inzicht geven in de prestaties, het gedrag en de gezondheid van elk onderdeel binnen een applicatie. Dankzij dit inzicht begrijpt u hoe de verschillende delen van het systeem op elkaar inwerken en elkaar beïnvloeden waardoor u problemen efficiënter kunt opsporen en oplossen.
Naarmate applicaties complexer worden, is volledig inzicht onmisbaar. Zonder full stack observability loopt u het risico inzichten te missen die uitvaltijd hadden kunnen voorkomen, de prestaties hadden kunnen verbeteren en bescherming hadden kunnen bieden tegen beveiligingsdreigingen.
De kerncomponenten van full stack observability
Voor effectieve full stack observability moet u verschillende kerncomponenten integreren:
Monitoringtools die realtime data vastleggen
Monitoringtools zijn essentieel om realtime data over de prestaties en gezondheid van een systeem vast te leggen. Ze verzamelen voortdurend metrics zoals CPU-gebruik, geheugenverbruik, netwerklatency en doorvoer. Met deze data herkent u afwijkingen en prestatieverlies op het moment dat ze optreden waardoor u tijdig kunt ingrijpen. Monitoringtools vormen de eerste verdedigingslinie tegen mogelijke problemen en geven direct zicht op de actuele status van een applicatie.
U kunt deze tools zo configureren dat ze uw teams waarschuwen zodra metrics vooraf ingestelde drempelwaarden overschrijden, zodat kritieke problemen meteen worden opgepakt. Door de verschillende aspecten van de systemen continu te monitoren, houdt uw organisatie een proactieve houding aan op het gebied van prestatiebeheer en voorkomt u dat kleine problemen uitgroeien tot grote.
Loggingtools voor historische data
Loggingtools volgen en bewaren historische data over gebeurtenissen en transacties binnen het systeem. Die logs leggen in detail vast wat er in de loop van de tijd is gebeurd, waardoor het eenvoudiger wordt om problemen te diagnosticeren die niet meteen zichtbaar zijn. Door logs te analyseren kunnen uw teams de oorzaak van problemen achterhalen, gebruikersgedrag begrijpen en inzicht krijgen in de werking van het systeem.
Logs zijn van onschatbare waarde voor analyse na een incident, omdat uw teams daarmee kunnen reconstrueren wat er aan een probleem voorafging. Dat historische perspectief is cruciaal om de context van afwijkingen te begrijpen en terugkerende patronen te herkennen die kunnen wijzen op diepere systeemproblemen. Goed logbeheer zorgt ervoor dat geen enkel detail over het hoofd wordt gezien en levert een volledig auditspoor van alle systeemactiviteit.
Tracingtools die het pad van verzoeken volgen
Tracingtools volgen het pad van afzonderlijke verzoeken terwijl die zich door de verschillende onderdelen van de applicatiestack bewegen. Dit end-to-end inzicht in de verzoekstromen helpt bij het opsporen van bottlenecks, latencyproblemen en storingspunten. Tracingtools laten tot in detail zien hoe elke service met de andere samenwerkt, zodat u prestatieproblemen en hun oorsprong precies kunt aanwijzen.
Tracing is vooral waardevol in microservices-architecturen, waar één verzoek talloze services kan passeren voordat het is afgerond. Door de route van elk verzoek in kaart te brengen, laten tracingtools zien welke services vertraging veroorzaken en waarom. Dankzij dit gedetailleerde inzicht kunt u gerichter optimaliseren en baseert u prestatieverbeteringen op concrete data.
Beter troubleshooten en presteren met full stack observability-tools
Full stack observability-tools verbeteren het troubleshooten en het optimaliseren van prestaties aanzienlijk. Met deze tools kunnen uw teams:
- Problemen snel opsporen en diagnosticeren: realtime monitoring en historische logging maken het mogelijk problemen snel te herkennen, wat de gemiddelde oplostijd (MTTR) verkort.
- Prestaties verbeteren: continue monitoring en analyse maken proactieve prestatie-afstemming mogelijk, zodat resources optimaal worden benut en uitvaltijd tot een minimum beperkt blijft.
- Holistische inzichten verwerven: full stack observability geeft een compleet beeld van de volledige applicatie en laat zien hoe de verschillende onderdelen elkaar en de prestaties van het hele systeem beïnvloeden.
Effectief troubleshooten valt of staat met uw vermogen om het volledige plaatje te zien. Full stack observability-tools geven u dat complete beeld, zodat u verder gaat dan het bestrijden van symptomen en de echte oorzaken aanpakt. Deze holistische aanpak lost niet alleen actuele problemen op maar voorkomt ook toekomstige problemen en verbetert zo de algehele stabiliteit en prestaties van uw applicatie.
Full stack observability zorgt daarnaast voor betere communicatie en samenwerking tussen uw teams. Met één gedeeld beeld van het systeem kunnen uw ontwikkelaars, operations en beveiligingsmedewerkers effectiever samenwerken en inzichten en strategieën voor continue verbetering delen. Zo’n samenwerkingsomgeving is onmisbaar om hoge standaarden voor prestaties en betrouwbaarheid te handhaven.
Beste praktijken en technieken voor full stack observability
Om full stack observability effectief te implementeren, moet u een aantal beste praktijken en technieken volgen:
Stel duidelijke observability-doelen vast
Bepaal wat u wilt observeren, zoals specifieke metrics, gebeurtenissen en transacties, en stem dit af op uw bedrijfsdoelstellingen. Die duidelijkheid helpt bij het stellen van prioriteiten en zorgt ervoor dat observability-initiatieven aansluiten op de doelen van de organisatie.
Duidelijke doelen vormen een roadmap voor uw observability-strategie en richten de inspanningen op de gebieden die de meeste waarde opleveren. Of uw prioriteit nu ligt bij een betere UX, efficiënter werken of sterkere beveiliging: goed gedefinieerde doelen sturen de keuze en implementatie van observability-tools en -praktijken.
Observability integreren in de development lifecycle
Observability integreren in uw development lifecycle is essentieel om continu inzicht te behouden. Pas observability-praktijken toe tijdens de ontwerp-, ontwikkel-, test- en implementatiefase. Zo wordt observability geen bijzaak maar een fundamenteel onderdeel van uw applicatiearchitectuur.
Door observability vanaf het begin mee te nemen, ontwerpt u systemen die eenvoudiger te monitoren en te troubleshooten zijn. Deze proactieve aanpak verkleint de kans op blinde vlekken en zorgt ervoor dat observability in elke fase van het ontwikkelproces is verankerd. Door observability-praktijken regelmatig te evalueren en bij te werken, blijven ze effectief naarmate uw applicatie zich verder ontwikkelt.
Ontdek hoe full stack observability uw IT-inzichten en prestaties verandert. Bekijk Wat is full stack observability en waarom is het belangrijk? en leer de basisprincipes en beste praktijken kennen.
Full stack observability inzetten voor betere bedrijfsresultaten
Met full stack observability krijgt u een gedetailleerd en samenhangend beeld van het volledige applicatielandschap, waardoor u uw activiteiten beter begrijpt en optimaliseert. Deze methode levert realtime inzicht in de systeemprestaties en helpt u problemen te herkennen en aan te pakken voordat ze uit de hand lopen. Door een soepele interactie met uw applicaties te garanderen, verhoogt u de tevredenheid van gebruikers aanzienlijk.
Beste praktijken voor full stack observability maken een efficiëntere inzet van resources mogelijk, verlagen de operationele kosten en verhogen de algehele productiviteit. Full stack observability integreren zorgt bovendien voor een betere afstemming tussen uw IT- en bedrijfsdoelstellingen en ondersteunt zo onderbouwde besluitvorming en strategische planning. Samen leiden deze voordelen uiteindelijk tot sterkere bedrijfsresultaten, waaronder:
- Een betere UX: door de volledige applicatiestack te monitoren en te optimaliseren zorgt u voor een soepele en responsieve gebruikerservaring, wat leidt tot meer tevreden klanten die langer blijven.
- Meer operationele efficiëntie: met full stack observability kunnen teams inefficiënties opsporen en processen optimaliseren, wat zorgt voor efficiëntere activiteiten en lagere kosten.
- Betere besluitvorming: volledig inzicht in de prestaties en het gedrag van het systeem levert waardevolle informatie voor onderbouwde beslissingen en vergroot de wendbaarheid van uw bedrijf.
Full stack observability is allang geen luxe meer maar een noodzaak voor moderne bedrijven. Het biedt het volledige inzicht dat nodig is om applicaties goed presterend, veilig en veerkrachtig te houden. Door de kerncomponenten te begrijpen, beste praktijken te volgen en observability in de development lifecycle te integreren, versterkt uw organisatie haar troubleshootingcapaciteit, optimaliseert u de prestaties en behaalt u betere bedrijfsresultaten.