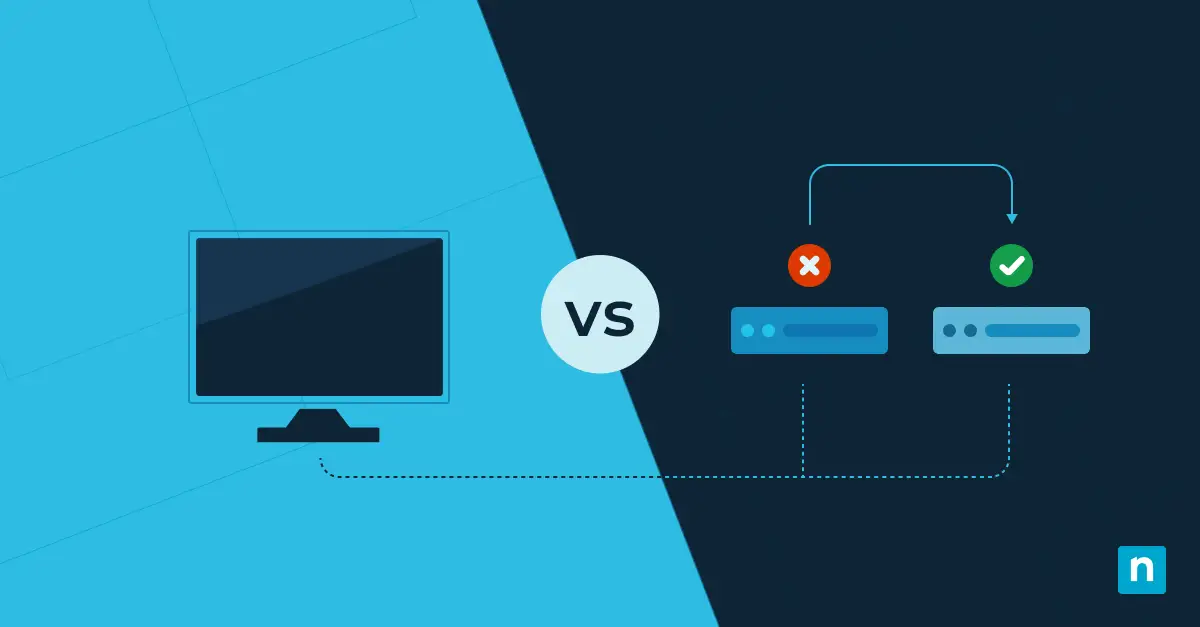
Alta disponibilidad vs tolerancia a fallos: ¿qué significan exactamente? Son dos conceptos de TI muy relacionados entre sí, pero con requisitos y resultados distintos. En este artículo analizamos la diferencia entre la alta disponibilidad (HA) y la tolerancia a fallos (FT) en el contexto de la infraestructura de TI, y destacamos sus diferencias clave, casos de uso y ventajas para que puedas asegurarte de que tu infraestructura cumple con sus necesidades concretas de fiabilidad y disponibilidad.
¿Qué es la alta disponibilidad (HA)?
La «disponibilidad» en este contexto se refiere a si los usuarios o servicios pueden acceder a un sistema. Si un sistema no está disponible, no puede realizar su tarea. La disponibilidad se mide por el tiempo total que un servicio está accesible al año: se espera que una aplicación con un 99% de disponibilidad lo esté 361,35 días al año (0,99 multiplicado por los 365 días del año). Muchas empresas ofrecen sus servicios online con un contrato que indica el nivel de disponibilidad que garantizan como parte de su acuerdo de nivel de servicio (SLA).
La alta disponibilidad es una arquitectura en la que los sistemas y el software se despliegan y configuran priorizando el tiempo de actividad y la capacidad de responder a las peticiones. Se considera alta disponibilidad a partir de un 99% de uptime y, en general, se espera que cualquier interrupción del servicio sea puntual y muy poco frecuente, si llega a producirse: una aplicación que promete un 99% de disponibilidad no debería estar fuera de servicio días seguidos, ni siquiera minutos, aunque así siguiera estando por debajo del margen establecido.
Aunque no presten servicios a otras empresas, muchas organizaciones necesitan alta disponibilidad para garantizar que su propio negocio funcione sin interrupciones. Por ejemplo, si tienes servidores que alojan tu software de ventas o de e-commerce, deberían centrarse en la alta disponibilidad para que los clientes nunca se queden sin poder comprarte.
¿Qué es la tolerancia a fallos (FT) y en qué se diferencia de la HA?
La tolerancia a fallos va un paso más allá que la alta disponibilidad: busca crear una infraestructura que no sufra ninguna interrupción. El objetivo es el mismo que en la alta disponibilidad (evitar cortes de servicio), pero los mecanismos necesarios para dotar de tolerancia a fallos a los sistemas son mucho más complejos y costosos.
Por eso, muchos equipos técnicos deciden que un determinado nivel de alta disponibilidad resulta más práctico y rentable que un sistema totalmente tolerante a fallos, o valoran si el 100% de uptime merece el coste adicional. Por ejemplo, que una tienda online diseñada para alta disponibilidad se caiga un par de segundos cuando no hay clientes (para corregir un bug o instalar una actualización) puede considerarse aceptable; en cambio, que un sistema de control del tráfico aéreo deje de funcionar periódicamente durante cualquier lapso de tiempo es del todo inaceptable, y todos los sistemas implicados deben tener cero tiempo de inactividad.
Así funcionan
Alta disponibilidad
La alta disponibilidad se apoya en varios mecanismos clave, según el tipo de servicios que se presten:
- Replicación y mirroring: la replicación garantiza que existan varias copias actualizadas de los datos almacenadas en servidores que funcionan sobre hardware independiente (incluso en ubicaciones distintas). Si uno falla, los usuarios pueden redirigirse rápidamente a otro servidor. La integridad de los datos debe monitorizarse y verificarse en todos los sistemas para confirmar que los datos están actualizados, completos y son correctos.
- Clústeres y balanceadores de carga: los servidores web, las bases de datos y otros servicios pueden alojarse en varios servidores y configurarse para repartir el tráfico entre ellos, de forma que ninguno se sature. Si un problema hace caer a un servidor del clúster, el servicio continúa sin interrupción porque los demás siguen funcionando.
- Redundancia y copia de seguridad: las copias de seguridad periódicas, además de las copias replicadas, permiten restaurar un estado correcto conocido si los datos se corrompen o dañan, o si un sistema queda irrecuperable.
- Hardware redundante: RAID es una tecnología habitual para protegerse frente al fallo de un disco. A nivel de red, contar con varios dispositivos de failover (por ejemplo, un router y una conexión a internet secundarios por si cae la conexión principal) evita que problemas como picos de tensión o cables cortados interrumpan el funcionamiento.
Tolerancia a fallos
La tolerancia a fallos añade más redundancia y detección de fallos para lograr una resiliencia total frente a las interrupciones. En esencia, un sistema tolerante a fallos combina varios sistemas de alta disponibilidad para que, en conjunto, el tiempo de inactividad se evite por completo aunque uno de esos sistemas HA falle del todo:
- Sistemas HA redundantes (incluida la redundancia geográfica): varios sistemas de alta disponibilidad, ya sean duplicados completos de toda la infraestructura de una aplicación o de sus componentes por separado, a los que se puede conmutar de inmediato en caso de caída. Lo ideal es que uno o varios de esos sistemas redundantes estén ubicados en otra región geográfica, para protegerse frente a catástrofes naturales u otras emergencias que puedan dejar un centro de datos completo fuera de servicio.
- Detección automática de fallos y vuelta al estado original: los sistemas tolerantes a fallos deben ser capaces de detectar los problemas en el momento en que se producen y mitigarlos al instante, por ejemplo conmutando a un sistema redundante mientras se investiga y se repara la incidencia. Una vez resuelta, el sistema debería volver automáticamente al estado para el que fue diseñado.
- Eliminar los puntos únicos de fallo: ningún sistema FT puede tener un punto único de fallo. La arquitectura del sistema y de todos sus componentes debe revisarse con regularidad para garantizar una redundancia total (y que los componentes redundantes funcionan).
- Contención de fallos: algunos errores pueden afectar a otra infraestructura y propagarse en cascada por los sistemas. Por ejemplo, valores de datos inesperados en un pipeline de datos pueden provocar fallos en las aplicaciones a medida que se transmiten. Los sistemas FT deberían monitorizar los fallos no críticos y aislarlos (por ejemplo, enviando los mensajes defectuosos a una dead letter queue en lugar de dejar que generen posibles errores críticos que afecten al uptime).
Una de las tecnologías clave tanto para los sistemas HA como FT es la monitorización y alertas automatizadas: si surge un problema, los equipos técnicos tienen que recibir el aviso para poder responder de inmediato y evitar cualquier corte del servicio.
Alta disponibilidad vs tolerancia a fallos: ventajas e inconvenientes
Al decidir qué nivel de alta disponibilidad quieres alcanzar en tu sistema, o si tiene sentido implementar una tolerancia a fallos completa, conviene valorar las implicaciones de coste, rendimiento y técnicas.
Los sistemas tolerantes a fallos son mucho más caros y complejos de implementar y mantener que los diseñados solo para alta disponibilidad. El motivo es que cada sistema debe contar con varios duplicados redundantes y, con cada duplicado, se multiplica el coste de implementación, además de los gastos continuos de alojamiento y mantenimiento. Por otro lado, cuanto mayor es tu infraestructura de TI, más difícil resulta gestionarla con un equipo pequeño si no se dispone de las herramientas adecuadas.
El rendimiento y la escalabilidad son otros factores a tener en cuenta: los componentes redundantes de un sistema FT no aportan rendimiento (solo entran en juego cuando se produce un fallo). En la HA, cuando se usan clústeres para el failover, las demás instancias activas sí pueden asumir parte de la carga de trabajo mediante un balanceador de carga, lo que mejora el rendimiento. Esto también puede resolverse en sistemas FT utilizando varios sistemas de alta disponibilidad redundantes (a un coste muy elevado).
Tanto en los sistemas de alta disponibilidad como en los tolerantes a fallos existe un consumo adicional de recursos por mantener copias redundantes de los datos, ya que hay que transferirlas y verificarlas: algo a tener en cuenta en casos de uso donde la latencia es crítica (por ejemplo, la negociación automatizada de valores en bolsa).
La alta disponibilidad y la infraestructura totalmente redundante se diseñan pensando en dos factores principales: evitar el tiempo de inactividad y recuperarse rápido si algo sale mal. Se espera que el objetivo de tiempo de recuperación (RTO) de las aplicaciones tolerantes a fallos sea cero, así que la recuperación tiene que ser instantánea. Para que lo sea, la integridad de los datos de las réplicas debe ser absoluta, por lo que los sistemas FT suelen poner más énfasis en la integridad de las réplicas de datos en vivo, mientras que los sistemas HA pueden pausarse y dedicar unos minutos a recuperarse a partir de una copia de seguridad correcta conocida.
Crea sistemas a prueba de balas. Mira Alta disponibilidad vs tolerancia a fallos: las principales diferencias y gana en resiliencia.
Alta disponibilidad y tolerancia a fallos: buenas prácticas
Al implementar tus propios sistemas de alta disponibilidad o tolerantes a fallos, asegúrate de cubrir estas tecnologías y procesos clave:
- Redundancia total: comprueba que no existe ningún punto único de fallo.
- Detección y respuesta automatizadas: implementa sistemas que identifiquen y mitiguen los problemas de forma automática, y que avisen a los equipos de ingeniería de cualquier incidencia potencial.
- Resiliencia geográfica: en los sistemas FT, asegúrate de tener sistemas redundantes disponibles en otra región. En la HA, procura que al menos haya un mirror de datos actualizado almacenado en una región distinta desde la que se pueda restaurar rápidamente.
- Vigila los costes: no subestimes el efecto acumulado de los costes de despliegue y mantenimiento, sobre todo en los sistemas tolerantes a fallos.
Puede que concluyas que la alta disponibilidad o la tolerancia a fallos no justifican el aumento de costes y recursos para el caso de uso de tu organización. Sin embargo, eso no significa que una de las herramientas en las que se apoyan deje de ser absolutamente crítica: las copias de seguridad. Por muy compleja (o sencilla) que sea tu infraestructura de TI, necesitas un plan de copias de seguridad sólido para que un accidente, un robo o un desastre no borren de golpe la valiosa información de la que dependes.