
Pontos principais
- Definição e finalidade do cluster de failover: é um grupo de servidores (nós) que transfere cargas de trabalho automaticamente quando ocorre uma falha, garantindo alta disponibilidade, inatividade mínima e continuidade dos negócios.
- Componentes essenciais e pré-requisitos: exige vários nós, software de gerenciamento do cluster, rede confiável e, muitas vezes, armazenamento compartilhado para detectar falhas e disparar um failover sem atritos.
- Como funciona o clustering de failover (etapas): o cluster monitora a saúde dos nós → detecta a falha → transfere automaticamente serviços e aplicativos para um nó saudável → restabelece as operações com o mínimo de interrupção.
- Tipos e configurações de clusters de failover: os modelos mais comuns são os clusters ativo-ativo e ativo-passivo, além das arquiteturas shared-disk e shared-nothing, cada uma com impacto em desempenho, custo e complexidade.
- Boas práticas para clusters de failover confiáveis: elimine pontos únicos de falha, teste o failover com regularidade, mantenha configurações consistentes entre os nós e monitore o desempenho para garantir resiliência, escalabilidade e tempo de atividade.
Operações contínuas e resiliência de sistemas são preocupações críticas na TI corporativa atual. E a tecnologia de cluster de failover pode ter papel decisivo para alcançar esses objetivos. Este artigo mergulha no funcionamento dos clusters de failover e nas suas aplicações. Seja um profissional de TI experiente ou um entusiasta curioso, continue a leitura. Vamos mostrar como entender os detalhes dos clusters de failover, como eles funcionam e em quais cenários se tornam indispensáveis.
O que é um cluster de failover?
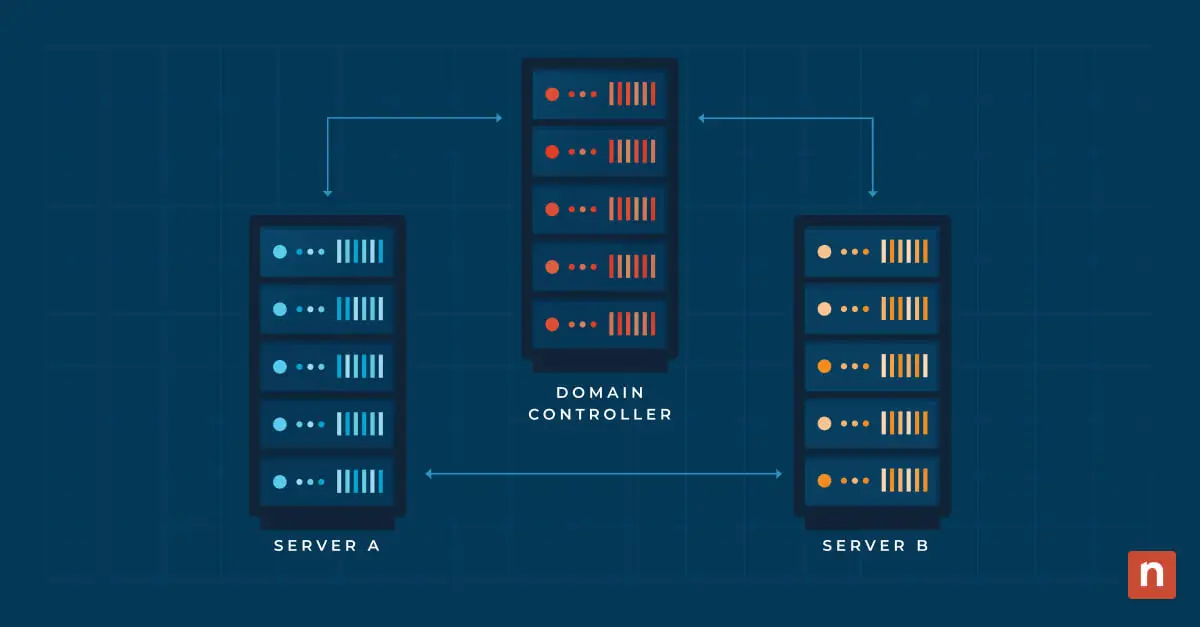
Um cluster de failover é uma forma especializada de infraestrutura de alta disponibilidade. Foi projetado para garantir operação ininterrupta em caso de falhas de hardware ou software. Na essência, é um grupo de computadores interconectados que funcionam juntos como um único sistema. O objetivo é oferecer redundância e disponibilidade contínua. A finalidade principal de um cluster de failover é detectar falhas em um dos componentes do sistema. Em seguida, ele transfere automaticamente a carga de trabalho para um componente em funcionamento, sem interrupção perceptível para os usuários.
Os componentes essenciais de um cluster de failover costumam incluir vários servidores (ou nós), recursos de armazenamento compartilhado e software de gerenciamento do cluster. Esse software monitora a saúde e o status dos nós. Quando detecta uma falha (como um defeito de hardware), o software de gerenciamento coordena o processo de failover. Isso envolve transferir a carga de trabalho e as responsabilidades do nó com problema para um nó saudável. A meta final é garantir que os serviços ou aplicativos continuem acessíveis e operacionais.
Fortaleça a resiliência operacional com as ferramentas de recuperação de desastres do NinjaOne.
Clusters de failover: alta disponibilidade e disponibilidade contínua
Alta disponibilidade é a capacidade de um sistema ou serviço de minimizar o tempo de inatividade recuperando-se rapidamente de falhas. Clusters de failover de alta disponibilidade normalmente conseguem detectar uma falha, iniciar o failover automaticamente e retomar as operações em um nó em espera. O objetivo é reduzir o tempo de inatividade ao mínimo. Assim, os serviços são restabelecidos rapidamente, sem grandes transtornos.
Já os clusters de disponibilidade contínua são um pouco diferentes: eles priorizam manter o serviço ininterrupto, com tempo de inatividade mínimo ou zero. A disponibilidade contínua envolve uma transição fluida dos serviços de um nó com falha para um nó saudável, de modo que o usuário final não perceba nenhuma interrupção. Isso costuma exigir replicação síncrona dos dados para o nó em espera.
Segurança e proteção por meio da redundância
Redundância é um conceito fundamental no contexto do clustering de failover. Refere-se à inclusão de componentes ou sistemas duplicados dentro de um cluster para garantir confiabilidade e tolerância a falhas. O objetivo principal da redundância é eliminar pontos únicos de falha. São vulnerabilidades do sistema que, se comprometidas, podem causar interrupções de serviço ou perda de dados. No clustering de failover, a redundância tem papel crucial. Ela ajuda a manter as operações mesmo quando um ou mais componentes falham.
Em um cluster de failover, a redundância é implementada de várias maneiras:
- Redundância de nós: clusters de failover são formados por vários nós, ou servidores individuais, que atuam juntos como um sistema unificado. Se um nó falha por problemas de hardware ou software, os demais nós do cluster assumem a carga de trabalho e evitam a inatividade. Assim, mesmo que um servidor fique indisponível, os serviços ou aplicativos migram sem atritos para outro nó em funcionamento.
- Redundância de armazenamento compartilhado: clusters costumam usar recursos de armazenamento compartilhado, como redes de área de armazenamento (SANs), para manter os dados consistentes em todos os nós. A redundância no armazenamento compartilhado é obtida com tecnologias como RAID (Redundant Array of Independent Disks), que protegem contra falhas de disco. Dessa forma, mesmo que um dispositivo de armazenamento falhe, os dados continuam acessíveis por mecanismos redundantes. Para se aprofundar nesses conceitos, incluindo orientações práticas sobre como as SANs são implementadas e por que trazem vantagens, confira O que é uma rede de área de armazenamento (SAN)? Benefícios e implementação.
- Redundância de rede: a comunicação entre os nós do cluster é vital para coordenação e sincronização de dados. A redundância de rede consiste em ter vários caminhos e interfaces de rede, para que o cluster continue se comunicando por rotas alternativas caso uma conexão falhe. Isso evita o isolamento dos nós e assegura disponibilidade contínua.
- Redundância de energia e hardware: fontes de alimentação redundantes, sistemas de refrigeração e outros componentes de hardware contribuem para a confiabilidade geral do cluster de failover. Essas medidas protegem contra falhas causadas por quedas de energia ou defeitos de hardware.
Por que o clustering de failover importa
O clustering de failover é essencial na infraestrutura de TI moderna, pois trata de aspectos críticos como alta disponibilidade e acesso contínuo a dados e serviços. Veja em detalhes a importância dessa tecnologia:
- Disponibilidade:
a alta disponibilidade é crucial para sistemas e aplicativos que precisam estar acessíveis o tempo todo. Ao distribuir cargas de trabalho entre vários nós, os clusters de failover garantem que, se um nó falhar, os serviços ou aplicativos passem sem atritos para um nó saudável. Em aplicativos críticos para o negócio, bancos de dados ou serviços web, manter a disponibilidade é fundamental para atender às expectativas dos usuários e sustentar operações ininterruptas.
- Redução do tempo de inatividade:
o tempo de inatividade pode ter consequências graves para as empresas, com perda de produtividade, receita e satisfação do cliente. O clustering de failover reduz a inatividade ao responder rapidamente a falhas de hardware ou software. O mecanismo de failover automático transfere a carga de trabalho de forma transparente para outro nó em funcionamento. Isso ajuda quando um nó falha, encurtando o tempo necessário para recuperar a disponibilidade do servidor.
- Continuidade de dados e serviços:
a continuidade de dados e serviços é o foco central do clustering de failover. Com componentes redundantes e mecanismos de failover, os clusters permitem que as organizações mantenham acesso ininterrupto a dados e serviços críticos. A redundância do armazenamento compartilhado garante consistência dos dados entre os nós. Já os mecanismos de failover para aplicativos e serviços asseguram que os usuários sigam com suas tarefas sem atritos. Isso é decisivo diante de falhas inesperadas. Esse nível de continuidade é vital para preservar a integridade dos dados, cumprir acordos de nível de serviço (SLAs) e construir uma infraestrutura de TI resiliente, capaz de enfrentar diferentes desafios.
- Otimização de recursos:
clusters de failover permitem usar os recursos com eficiência, alocando cargas de trabalho conforme a saúde e a capacidade de cada nó. Essa otimização ajuda as organizações a extrair o máximo dos investimentos em hardware. E faz isso garantindo que os recursos computacionais sejam alocados onde há maior necessidade em cada momento.
- Manutenção simplificada:
clusters de failover facilitam as atividades de manutenção sem interromper os serviços. Eles permitem uma abordagem não disruptiva para a manutenção do sistema. Isso acontece porque os administradores podem tirar nós do ar para manutenção ou atualizações enquanto os nós restantes continuam atendendo à carga de trabalho.
Tipos de clusters de failover
Os clusters de failover se dividem em dois tipos principais: shared-nothing e shared-disk. Cada um atende a requisitos específicos. A escolha entre eles depende de fatores como o caso de uso. Também pode depender das necessidades de escalabilidade e da disposição da organização em lidar com complexidade.
- Clusters de failover shared-nothing
Em um cluster shared-nothing, cada nó opera de forma independente, com seu próprio conjunto de recursos, incluindo armazenamento local. Esses clusters usam uma rede comum para comunicação. Mesmo que empreguem armazenamento compartilhado para configuração ou como disco testemunha, os dados dos aplicativos não são compartilhados diretamente. Os clusters shared-nothing costumam ser preferidos pela simplicidade e pelo menor risco de ponto único de falha. Por outro lado, podem ter limitações de escalabilidade e gerar aumento do tráfego de rede durante os failovers.
- Clusters de failover shared-disk
Esses clusters oferecem um sistema de armazenamento centralizado, em que todos os nós compartilham acesso aos dados dos aplicativos. Normalmente é uma rede de área de armazenamento (SAN) ou um armazenamento conectado à rede (NAS). Um cluster shared-disk oferece escalabilidade, já que novos nós ampliam a capacidade de processamento e de armazenamento. Em compensação, clusters shared-disk tendem a ser mais complexos de configurar. Também são mais difíceis de gerenciar por causa das configurações de armazenamento compartilhado. E pode haver preocupação com disputa por recursos quando vários nós acessam o mesmo armazenamento.
Clusters de failover em Hyper-V, Windows Server e VMware
Alguns tipos de cluster de failover estão ligados a plataformas de virtualização populares. É o caso do Hyper-V (Microsoft) e do VMware. Vamos ver os diferentes tipos de cluster de failover no contexto dessas plataformas:
Tipos de cluster de failover no Hyper-V
Clusters de hosts Hyper-V
Em um cluster Hyper-V, vários servidores físicos (os nós já mencionados) formam um cluster para hospedar e gerenciar máquinas virtuais (VMs) em conjunto. Se um nó falha, as VMs migram automaticamente para outro nó saudável do cluster, o que garante disponibilidade contínua.
Vantagens:
- Alta disponibilidade para cargas de trabalho virtualizadas.
- Migração automática de VMs em caso de falha de nó.
Pontos de atenção:
- Exige armazenamento compartilhado para os arquivos das VMs.
Hyper-V Replica
O Hyper-V Replica faz a replicação assíncrona de VMs de um host Hyper-V para outro. Se o host primário falhar, a VM replicada pode ser ativada no host secundário, reduzindo o tempo de inatividade.
Vantagens:
- Separação geográfica para recuperação de desastres.
- Replicação assíncrona para maior flexibilidade.
Pontos de atenção:
- Envolve certo grau de perda de dados em caso de failover.
Tipos de Windows Server Failover Cluster (WSFC)
Clusters de failover de servidor de arquivos
Os Windows Server Failover Clusters (WSFCs) podem ser configurados para oferecer alta disponibilidade aos serviços de servidor de arquivos. Vários nós trabalham juntos para garantir acesso a arquivos e pastas compartilhados, com failover automático em caso de falha de nó ou de serviço.
Vantagens:
- Acesso contínuo aos arquivos pelos usuários.
- Recuperação automática de falhas de nó.
Pontos de atenção:
- Exige armazenamento compartilhado para os arquivos compartilhados.
Clusters de failover do SQL Server
Clusters de failover podem ser implementados para dar alta disponibilidade a bancos de dados do SQL Server. Vários nós hospedam instâncias do SQL Server. E, em caso de falha, os serviços migram sem atritos para outro nó.
Vantagens:
- Disponibilidade contínua dos bancos de dados do SQL Server.
- Failover automático para reduzir ao máximo a inatividade.
Pontos de atenção:
- Exige armazenamento compartilhado para os arquivos de banco de dados.
Tipos de cluster de failover no VMware
vSphere High Availability (HA)
O VMware vSphere HA oferece alta disponibilidade para máquinas virtuais em um cluster vSphere. Se um host falha, as VMs são reiniciadas automaticamente em outros hosts do cluster.
Vantagens:
- Reinício automático das VMs para operação contínua.
- Dispensa armazenamento compartilhado.
Pontos de atenção:
- Pode haver breve inatividade da VM durante o failover.
Fault Tolerance (FT)
O VMware FT garante disponibilidade contínua ao manter uma cópia secundária da VM em outro host. Se o host primário falha, a VM secundária assume sem interrupção.
Vantagens:
Zero tempo de inatividade durante falhas de host.
Proteção contínua no nível da VM.
Pontos de atenção:
Exige armazenamento compartilhado e suporte específico de hardware.
Variações de clusters híbridos
Essas configurações combinam elementos de diferentes tecnologias ou plataformas para atingir objetivos específicos. Dois exemplos de clusters híbridos são os clusters de failover do SQL Server e os clusters Red Hat Linux. Vamos ver cada um:
Clusters de failover do SQL Server
Um cluster de failover do SQL Server é uma configuração híbrida que combina o SQL Server da Microsoft com o Windows Server Failover Clustering. Nesse arranjo, vários nós hospedam instâncias do SQL Server e o cluster de failover garante alta disponibilidade do banco de dados.
Vantagens:
- Disponibilidade contínua dos bancos de dados do SQL Server.
- Failover automático em caso de falha de nó ou de serviço.
- Usa o Windows Server Failover Clustering para maior confiabilidade.
Pontos de atenção:
- Exige armazenamento compartilhado para os arquivos de banco de dados.
- Os recursos do Windows Server Failover Clustering são parte integrante das capacidades de failover do SQL Server.
Clusters Red Hat Linux
Os clusters Red Hat Linux costumam ser montados com tecnologias como Pacemaker e Corosync. Isso ajuda a criar configurações de alta disponibilidade para aplicativos e serviços em sistemas baseados em Linux. Esses clusters podem ser híbridos. Isso ocorre no sentido de que podem se integrar a soluções de armazenamento de diferentes fornecedores, tecnologias de virtualização ou serviços de nuvem.
Vantagens:
- Alta disponibilidade para aplicativos e serviços baseados em Linux.
- Flexibilidade para integrar diversas tecnologias de armazenamento e virtualização.
- Adequados a implantações locais ou na nuvem.
Pontos de atenção:
- Exige conhecimento e configuração das tecnologias de clustering do Linux.
- Os aspectos híbridos podem envolver questões de compatibilidade com soluções de terceiros.
- Essas variações de clusters híbridos mostram a flexibilidade e a adaptabilidade das tecnologias de clustering para atender a necessidades específicas em diferentes plataformas.
Como funcionam os clusters de failover
Os clusters de failover funcionam formando um grupo de servidores interconectados, chamados de nós. Eles colaboram para garantir alta disponibilidade e operação contínua de serviços ou aplicativos. O objetivo principal é detectar e responder a falhas de hardware ou software. E, no fim das contas, reduzir o tempo de inatividade e manter a continuidade do serviço. O mecanismo envolve as seguintes etapas:
- Formação do cluster
Vários nós são conectados a uma rede compartilhada, criando um cluster. O cluster pode usar armazenamento compartilhado ou outros recursos compartilhados, dependendo do tipo de cluster, como descrito na seção anterior.
- Monitoramento da saúde
O software de gerenciamento do cluster monitora continuamente a saúde e o status de cada nó. O monitoramento inclui verificar falhas de hardware, conectividade de rede e disponibilidade de serviços críticos.
- Comunicação por heartbeat
Os nós se comunicam entre si por meio de um processo chamado comunicação por heartbeat.Os heartbeats são sinais trocados entre os nós em intervalos regulares para confirmar a saúde e a disponibilidade de cada um. Se um nó para de enviar heartbeats ou é considerado com problemas, o software de gerenciamento identifica esse nó como possível ponto de falha.
- Propriedade de recursos e políticas de failover
Cada nó do cluster é capaz de hospedar e gerenciar os serviços ou aplicativos. As políticas de failover e as regras de propriedade de recursos definem qual nó responde por determinados serviços em cada momento. Essas políticas garantem que outro nó saudável possa assumir a carga de trabalho se um nó falhar.
- Failover automático
Diante de uma falha, o software de gerenciamento do cluster dispara o processo de failover automático. O failover transfere os serviços ou aplicativos do nó com falha para um nó saudável do cluster. Esse processo costuma ser transparente para os usuários e reduz os transtornos ao mínimo.
- Armazenamento compartilhado (opcional)
Em alguns clusters de failover, o armazenamento compartilhado guarda dados ou configurações dos aplicativos. Ele permite acesso consistente aos dados entre os nós e facilita um failover sem atritos.
- Intervenção manual (opcional)
Em certos cenários, os administradores podem precisar intervir manualmente, principalmente em manutenções programadas ou ao lidar com problemas específicos. As intervenções manuais garantem que o processo de failover esteja alinhado aos requisitos e às políticas da organização.
- Recuperação e redundância
Depois do failover, o cluster segue operando com os nós saudáveis restantes. Quando o nó com falha é restaurado ou um substituto entra em operação, o cluster pode reequilibrar seus recursos. Ou voltar à configuração original.
Com essas etapas, os clusters de failover oferecem uma solução robusta para manter alta disponibilidade e reduzir a inatividade em ambientes de computação críticos.
Aplicações do clustering de failover
Os clusters de failover são usados nos mais diversos setores e oferecem soluções robustas para continuidade de negócios, recuperação de desastres, escalabilidade e balanceamento de carga. Estes exemplos reais mostram sua versatilidade:
Finanças: continuidade de negócios e recuperação de desastres (BCDR)
Bancos e instituições financeiras implantam clusters de failover para garantir a disponibilidade contínua de serviços críticos. Isso inclui o internet banking e o processamento de transações. Se um servidor falha, os mecanismos de failover asseguram serviço ininterrupto e evitam transtornos financeiros para os clientes.
Plataformas de e-commerce: máximo tempo de atividade
Varejistas on-line usam clusters de failover para manter os sites de e-commerce no ar. Especialmente em períodos de alto tráfego ou diante de falhas de servidor. Essa disponibilidade contínua é crucial para a satisfação do cliente e a receita.
Provedores de nuvem: escalabilidade e balanceamento de carga
Provedores de nuvem usam clusters de failover para escalar seus serviços de forma dinâmica. Conforme a demanda cresce, novos nós podem ser adicionados ao cluster para dar conta da carga de trabalho. Os mecanismos de balanceamento de carga garantem o uso ideal dos recursos e entregam aos clientes serviços de nuvem confiáveis e escaláveis.
Redes de distribuição de conteúdo (CDNs): velocidade e eficiência
As CDNs empregam clusters de failover para garantir entrega de conteúdo rápida e confiável. Nós espalhados pelo mundo atendem às solicitações dos usuários. E o processo de failover redireciona o tráfego sem atritos para nós saudáveis, evitando interrupções e otimizando a entrega de conteúdo.
Redes de telecomunicações: conectividade confiável
Empresas de telecomunicações implantam clusters de failover em suas redes para sustentar serviços de voz e dados. Em caso de congestionamento, o failover redireciona os serviços de comunicação para nós alternativos e mantém a conectividade dos usuários.
Indústria: planejamento de recuperação de desastres
Fábricas usam clusters de failover para garantir a continuidade dos sistemas de produção e de cadeia de suprimentos. Se um servidor falha, o failover assegura que os processos industriais e o atendimento de pedidos sigam sem impacto, reduzindo transtornos.
Governo e serviços públicos: continuidade das operações
Órgãos públicos implantam clusters de failover em serviços essenciais, como processamento de tributos ou sistemas de resposta a emergências. A capacidade de failover garante que funções governamentais essenciais continuem, mesmo em eventos inesperados ou desastres.
Quer melhorar o tempo de atividade dos sistemas? Assista a o que é um cluster de failover? Como funciona e aplicações.
Reduza a inatividade cara e garanta a continuidade dos negócios com NinjaOne.
O impacto do clustering de failover
Como vimos, o clustering de failover é decisivo para manter as operações ininterruptas. Em especial, as de sistemas de TI críticos nos mais variados setores. Essa tecnologia robusta, comprovada em aplicações reais, é essencial para continuidade de negócios, recuperação de desastres, escalabilidade e balanceamento de carga.
A importância do clustering de failover na TI está na capacidade de manter a alta disponibilidade. Ele também otimiza o uso de recursos e contribui muito para a resiliência e a eficiência das organizações em um cenário tecnológico em constante evolução.
Se quiser construir uma infraestrutura de TI robusta, vale a pena se aprofundar no clustering de failover.






