Punti chiave
- Monitoraggio proattivo per MSP: Implementa l’automazione per monitorare lo stato di integrità dei dispositivi, le applicazioni, la rete, le unità disco e la sicurezza, al fine di prevenire i tempi di inattività, ridurre il sovraccarico di avvisi e migliorare l’erogazione dei servizi IT.
- Controlli di integrità sui dispositivi: Monitora il tempo di attività, gli endpoint offline, i riavvii imprevisti e le modifiche hardware per individuare tempestivamente i problemi e automatizzare la risoluzione, quando è possibile.
- Automazione del monitoraggio delle unità disco e dello storage: Monitora i guasti dei dischi SMART, lo stato di integrità dei RAID, l’utilizzo dei dischi e le soglie di spazio libero per evitare la perdita di dati e i colli di bottiglia nelle prestazioni.
- Monitoraggio delle applicazioni: Assicurati che le applicazioni e i servizi aziendali critici (Exchange, SQL, AD, strumenti di produttività) siano installati, in esecuzione e non consumino risorse in eccesso.
- Visibilità della rete: Monitora i picchi di utilizzo di banda, le porte aperte, il tempo di attività dei dispositivi e la disponibilità dei siti web dei clienti per garantire una connettività affidabile.
- Automazione della sicurezza: Rileva lo stato dei firewall, l’installazione di antivirus/EDR e la presenza di minacce, i tentativi di accesso non riusciti, le modifiche non autorizzate agli account e la conformità alla crittografia del disco.
- Monitoraggio dei backup: Automatizza gli avvisi relativi ai processi di backup non riusciti su NinjaOne Backup, Veeam, Acronis e altre soluzioni per garantire la protezione dei dati.
- Riduci lo stress da avvisi: Utilizza avvisi che consentono di intervenire, classifica i ticket, automatizza la risoluzione dei problemi più comuni e ottimizza le soglie per ridurre l’eccesso di avvisi.
- Best practice per MSP: Crea modelli di monitoraggio di riferimento, allineali alle priorità di ogni cliente, tieni traccia dei problemi ricorrenti e organizza sessioni periodiche di gestione degli avvisi.
Il monitoraggio degli endpoint e gli avvisi sono una parte centrale della gestione IT. Se sei un MSP, applicare le best practice di monitoraggio e di invio degli avvisi ti consente di individuare in modo proattivo i problemi, risolverli più rapidamente e risparmiare tempo e frustrazione sia a te che ai tuoi utenti nel lungo periodo.
La sfida sta nel capire
- quali aspetti tenere sotto controllo,
- cosa richiede un avviso,
- quali problemi possono essere risolti automaticamente, e
- quali richiedono una risoluzione personalizzata.
Acquisire tali competenze può richiedere anni e, anche in quel caso, i migliori team IT possono comunque avere difficoltà a ridurre lo stress da avvisi e da eccesso di ticket sulle proprie reti e sui propri dispositivi.
Per ridurre i tempi e per restringere il campo d’azione, abbiamo messo insieme un elenco di idee sulle condizioni da monitorare, insieme ai trigger e alle azioni suggerite per l’automazione. Queste indicazioni si basano sui suggerimenti dei nostri clienti e sull’esperienza di NinjaOne nell’aiutare i team IT a implementare un monitoraggio più efficace e orientato all’azione.
Come utilizzare l’elenco di controllo per il monitoraggio MSP riportato di seguito
Per ciascuna condizione, descriviamo cosa viene monitorato, come configurare il monitoraggio in NinjaOne e quali azioni intraprendere qualora la condizione venisse attivata. Alcuni suggerimenti per il monitoraggio sono concreti, mentre altri potrebbero richiedere un livello minimo di personalizzazione per essere adattati al tuo caso d’uso.
Nota: Questo elenco di controllo è stato creata pensando a NinjaOne e ai propri clienti, ma queste idee per il monitoraggio dovrebbero essere facilmente applicabili a qualsiasi soluzione RMM o di gestione degli endpoint.
Inoltre, questo elenco ovviamente non è esaustivo e potrebbe non adattarsi a qualsiasi situazione o circostanza.
Una volta che avrai iniziato a definire il tuo piano di monitoraggio sulla base di questi suggerimenti, ti consigliamo di sviluppare una strategia di monitoraggio più personalizzata e solida, specifica per le tue esigenze. Concluderemo questo post con ulteriori suggerimenti utili per realizzare tutto questo e per rendere il monitoraggio, gli avvisi e il ticketing più semplici ed efficaci.
Monitoraggio dell’integrità dei dispositivi
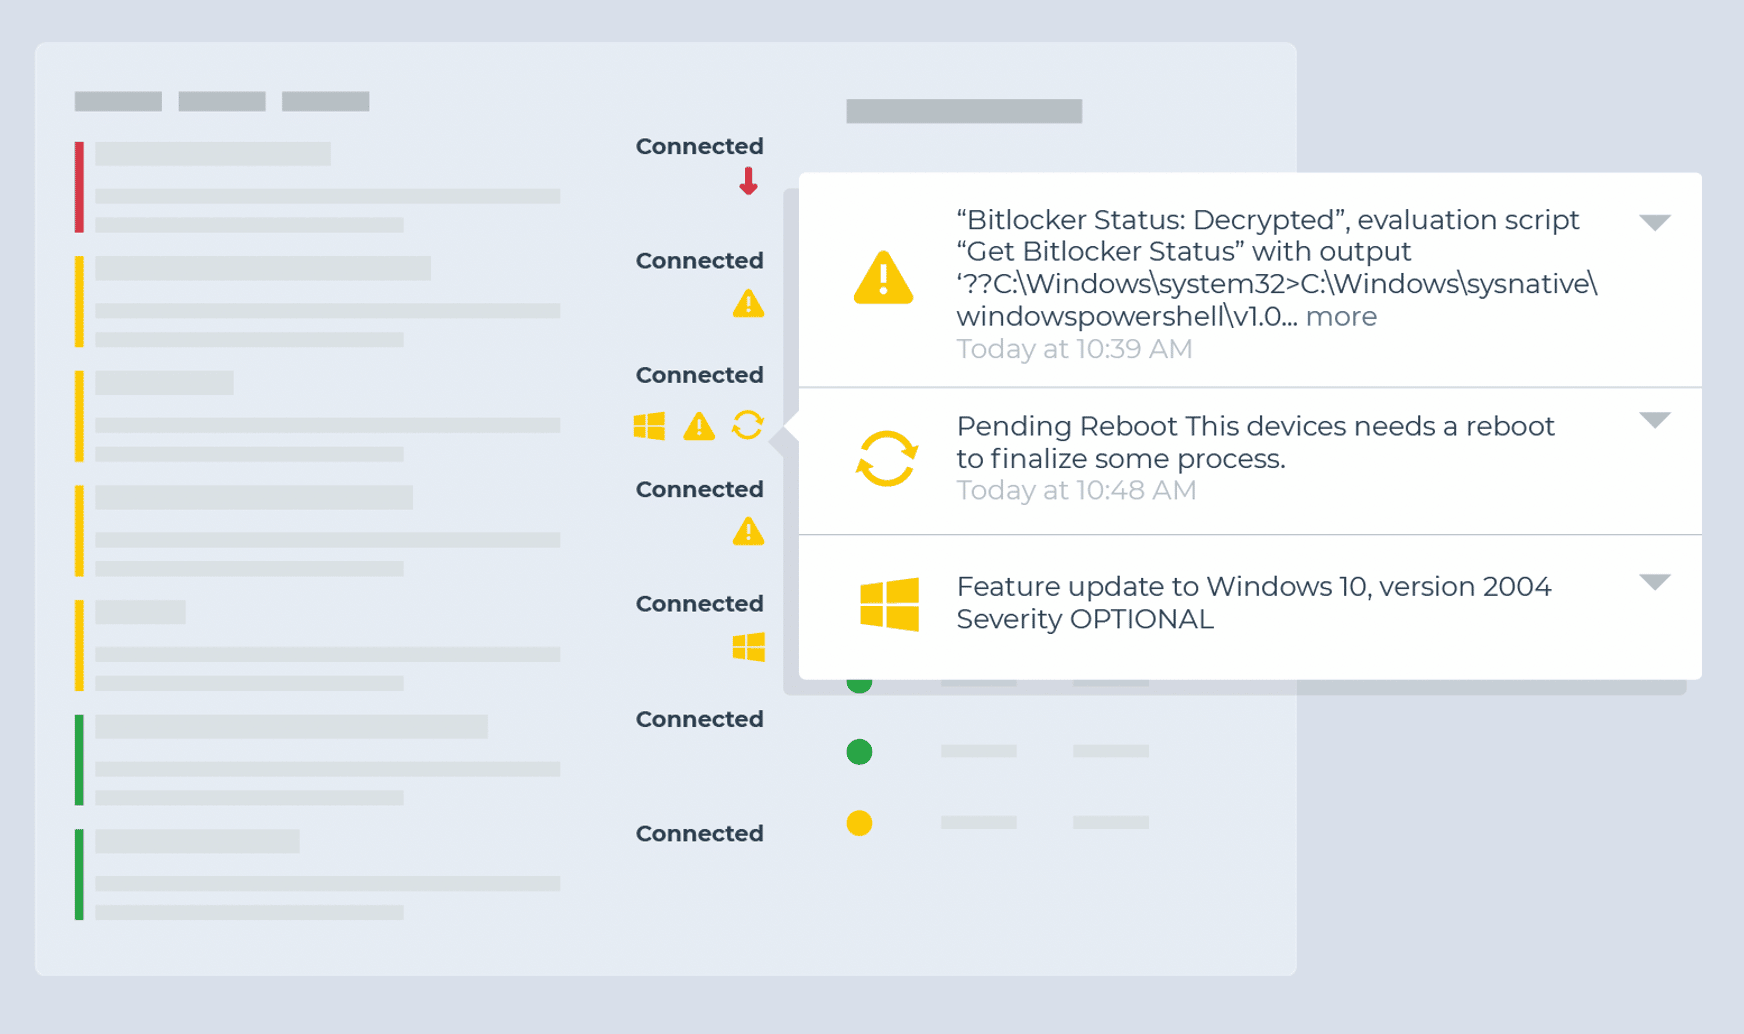
Monitoraggio continuo degli eventi critici
- Condizione: Eventi critici
- Soglia: 80 eventi critici in 5 minuti
- Nota: Potrebbe essere necessario regolare con precisione la soglia o applicare filtri di esclusione, poiché questa automazione potrebbe generare un eccesso di avvisi in ambienti con log molto dettagliati.
- Azione: Creazione di un ticket e inizio dell’indagine
Identificare quando un dispositivo viene riavviato involontariamente
- Condizione: Evento Windows
- Origine dell’evento: Microsoft-Windows-Kernel-Power
- ID evento: 41
- Nota: Questa condizione è più indicata per i server poiché workstation e portatili possono dare questo errore in seguito all’intervento dell’utente.
- Azione: Creazione di un ticket e inizio dell’indagine
Identificare i dispositivi che richiedono un riavvio
- Condizione: Tempo di attività del sistema
- Raccomandazione relativa alla soglia: 30 o 60 giorni (anche se potrebbe risultare un periodo troppo breve per i server con carichi di lavoro stabili)
- Azione: Riavviare il dispositivo in un intervallo appropriato. La correzione automatizzata potrebbe funzionare per le workstation.
Monitoraggio degli endpoint offline
- Condizione: Dispositivo non disponibile
- Raccomandazione relativa alla soglia:
- 10 minuti o meno (server)
- Più di 24 ore (workstation)
- Azione:
- Creazione di un ticket e inizio dell’indagine
- Wake-on-LAN (solo server)
Monitoraggio delle modifiche dell’hardware
- Attività: Sistema
- Nome: Scheda aggiunta/modificata, CPU aggiunta/rimossa, Unità disco aggiunta/rimossa, Memoria aggiunta/rimossa
- Azione: Creazione di un ticket e inizio dell’indagine
Monitoraggio delle unità
Monitorare i potenziali errori del disco
- Condizione: Stato SMART di Windows “Degradato” e/o “ – Evento di Windows
- Origine dell’evento: Disco
- ID evento: 7, 11, 29, 41, 51, 153
- Azione: Creazione di un ticket e inizio dell’indagine
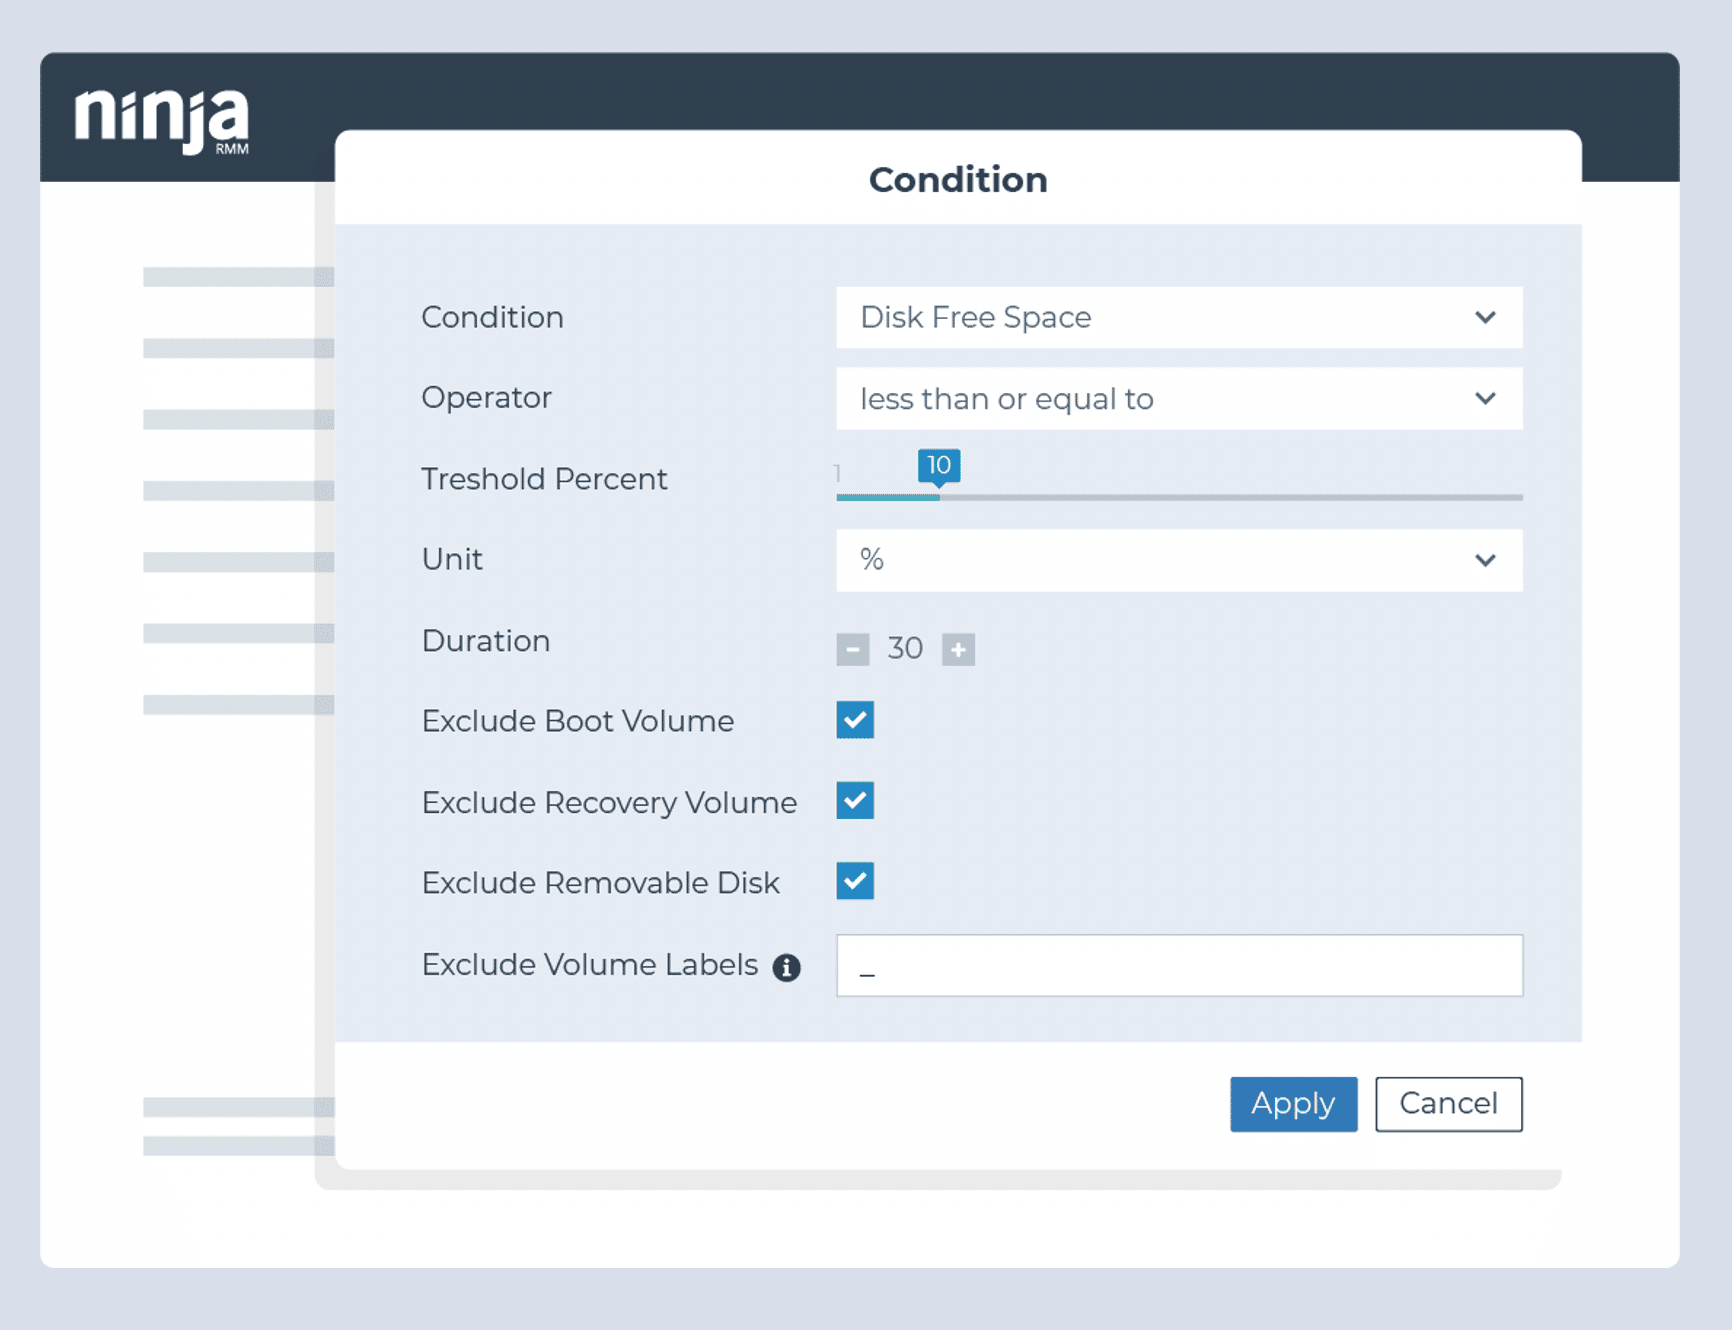
Individuare quando lo spazio su disco sta finendo
- Condizione: Spazio disponibile su disco
- Soglia: 20% e di nuovo al 10%
- Azione: Pulizia del disco ed eliminazione dei file temporanei
Monitorare i potenziali errori RAID
- Condizione: Stato di integrità RAID
- Soglie: Critico e non critico per tutti gli attributi
- Azione: Creazione di un ticket e inizio dell’indagine
Monitoraggio dell’utilizzo prolungato del disco
- Condizione: Utilizzo del disco
- Soglie: 90% o superiore per ridurre l’eccesso di avvisi, con più del 95% comune in periodi di 30 o 60 minuti
- Azione: Creazione di un ticket e inizio dell’indagine
Monitorare l’elevato tasso di attività del disco
- Condizione: Tempo di attività del disco
- Soglie: Più del 90% per 15 minuti
- Azione: Creazione di un ticket e inizio dell’indagine
Monitoraggio di un utilizzo elevato della memoria
- Condizione: Utilizzo della memoria
- Soglie: Più del 90% per 15 minuti
- Azione: Creazione di un ticket e inizio dell’indagine
Monitora le applicazioni

Identifica se esistono le applicazioni richieste su un endpoint
- Condizione: Software
- Utilizzo:
- Applicazioni aziendali dei clienti (per esempio AutoCAD, SAP, Photoshop)
- Soluzioni per la produttività dei clienti (per esempio Zoom, Microsoft Teams, DropBox, Slack, Office, Acrobat)
- Strumenti di assistenza clienti (per esempio TeamViewer, CCleaner, AutoElevate, BleachBit)
- Azione: Segnalare le app richieste mancanti affinché vengano esaminate o, se necessario, distribuite automaticamente
Monitorare se le applicazioni critiche sono in esecuzione (soprattutto per i server)
- Condizione: Processo o servizio
- Soglia: Non disponibile per almeno 3 minuti
- Processi di esempio:
- Per le workstation: TeamViewer, RDP, DLP
- Per un server Exchange: MSExchangeServiceHost, MSExchangeIMAP4, MSExchangePOP3
- Per un server Active Directory: Netlogon, dnscache, rpcss
- Per un server SQL: mssqlserver, sqlbrowser, sqlwriter
- Azione: Riavvio del servizio o del processo
Monitorare l’utilizzo delle risorse per le applicazioni che possono causare problemi relativi alle prestazioni
- Condizione: Risorsa di processo
- Soglia: Più del 90% per almeno 5 minuti
- Processi di esempio: Outlook, Chrome e TeamViewer
- Azione:
- Creazione di un ticket e inizio dell’indagine
- Disabilitare all’avvio
Monitorare gli arresti anomali delle applicazioni
- Condizione: Evento Windows
- Origine: Blocco dell’applicazione
- ID evento: 1002
- Azione: Creazione di un ticket e inizio dell’indagine
Monitoraggio della rete

Monitorare l’utilizzo imprevisto della larghezza di banda
- Condizione: Utilizzo della rete
- Direzione: In uscita
- Soglia: Dipende dal tipo di endpoint e dalla capacità della rete
- Ogni server deve avere una propria soglia in base al suo caso d’uso specifico
- Le soglie di monitoraggio della rete per le workstation devono essere abbastanza elevate, in modo da attivarsi solo quando la rete di un cliente è a rischio
- Azione: Creazione di un ticket e inizio dell’indagine
Garantire il corretto funzionamento dei dispositivi di rete
- Condizione: Dispositivo non disponibile
- Durata: 3 minuti
Monitorare le porte aperte
- Condizione: Monitoraggio cloud
- Porte: 80 (HTTP), 443 (HTTPS), 25 (SMTP), 21 (FTP)
Monitorare la disponibilità del sito Web del cliente
- Monitoraggio: Ping
- Destinazione: Sito Web del cliente
- Condizione: Errore (5 volte)
- Azione: Creazione di un ticket e inizio dell’indagine
Monitoraggio della sicurezza di base

Identificare se il firewall di Windows è stato disattivato
- Condizione: Evento Windows
- Origine dell’evento: Sistema
- ID evento: 5025
- Azione: Attivazione di Windows Firewall
Identificare se l’antivirus e gli strumenti di sicurezza sono installati e/o in esecuzione su un endpoint
- Condizione: Software
- Presenza: Non esiste
- Esempi di software: Huntress, Cylance, Threatlocker, Sophos
- Azione: Automatizzare l’installazione del software di sicurezza mancante
- Condizione: Processo o servizio
- Stato: Inattivo
- Processi di esempio: threatlockerservice.exe, EPUpdateService.exe
- Azione: Riavvio del processo
Monitoraggio delle minacce AV/EDR rilevate ma non integrate
- Condizione: Evento Windows
- Esempio: Sophos
- Origine dell’evento: Sophos Anti-Virus
- ID evento: 6, 16, 32, 42
Monitorare i tentativi di accesso dell’utente non riusciti
- Condizione: Evento Windows
- Origine dell’evento: Microsoft-Windows-Security-Auditing
- ID evento: 4625, 4740, 644 (account locali); 4777 (accesso al dominio)
- Azione: Creazione di un ticket e inizio indagine
Monitorare la creazione, la modifica o la rimozione di utenti su un endpoint
- Condizione: Evento Windows
- Origine dell’evento: Microsoft-Windows-Security-Auditing
- ID evento: 4720, 4732, 4729
- Azione: Creazione di un ticket e inizio indagine
Monitoraggio per identificare se le unità in un endpoint sono crittografate/decrittografate
- Condizione: Risultato dello script
- Script (personalizzato): Verifica dello stato della crittografia
- Azione: Creazione di un ticket e inizio dell’indagine
Monitoraggio degli errori di backup (NinjaOne Backup)
- Attività: NinjaOne Backup
- Nome: Processo di backup non riuscito
Monitorare gli errori di backup (altri fornitori di soluzioni per il backup)
- Condizione: Evento Windows
- Esempi di orgine/ID (Veeam):
- Origine dell’evento: Agente Veeam
- ID evento: 190
- Contenuto del testo: Non riuscito
- Esempi di origine/ID (Acronis):
- Origine dell’evento: Sistema di backup online
- ID evento: 1
- Contenuto del testo: Non riuscito
4 consigli per migliorare il monitoraggio del tuo MSP
- Crea un modello di monitoraggio dell’integrità dei dispositivi di base.
- Parla con i clienti delle loro priorità.
- Quali server e workstation sono importanti?
- Quali sono le loro applicazioni chiave per le attività aziendali o per la produttività?
- Quali criticità hanno riscontrato in ambito IT?
- Controlla il tuo sistema PSA/di ticketing per individuare eventuali problemi ricorrenti. Inoltre, regola le impostazioni degli avvisi per evitare l’eccesso di ticket.
- Monitora i log eventi dei clienti per individuare eventuali problemi ricorrenti.
Best practice per ticketing e avvisi
- Attiva avvisi solo su informazioni utilizzabili. Se non hai una risposta specifica per un monitoraggio, non eseguire il monitoraggio.
- Categorizza gli avvisi in modo da indirizzarli verso schede di servizio diverse nel PSA in base al tipo o alla priorità.
- Organizza riunioni periodiche di coordinamento per rispondere alle seguenti domande:
- Quali avvisi causano gran parte del rumore? È possibile rimuoverli o limitarli?
- Cosa non viene monitorato o non genera notifiche, mentre invece dovrebbe?
- Quali avvisi comuni è possibile risolvere automaticamente?
- Ci sono dei progetti imminenti che potrebbero generare avvisi?
- Elimina i ticket e gli avvisi una volta risolti.
- In NinjaOne, molte condizioni prevedono l’opzione “Reimposta quando non è più vera” o “Reimposta quando non è vera per un periodo di x”, per aiutarti a risolvere e ripulire le notifiche che potrebbero risolversi da sole.
Ulteriori idee sul monitoraggio per MSP
Non perdere la straordinaria serie di Kelvin Tegelaar sul monitoraggio da remoto tramite PowerShell. In questa serie, Kelvin come monitorare ogni aspetto, dal traffico di rete allo stato di Active Directory, agli accessi non riusciti a Office 365, fino ad arrivare ai risultati di Shodan e altro ancora. Ma soprattutto, condivide gli script di PowerShell progettati per essere utilizzati con qualsiasi RMM. Puoi leggere anche il nostro post del blog sulle differenze tra PowerShell e il prompt dei comandi e su quando usare uno strumento o l’altro.
Nella nostra newsletter settimanale MSP Bento pubblichiamo regolarmente i post del blog di Tegelaar, insieme a numerosi strumenti e risorse aggiuntive. Iscriviti ora per ricevere la versione più recente e un elenco speciale delle risorse e degli strumenti più popolari che abbiamo condiviso.
Inoltre, se stai cercando un software che ti aiuti ad automatizzare il monitoraggio di tutte le tue risorse IT, NinjaOne IT Asset Management ti offre una panoramica completa e in tempo reale delle risorse e ti consente di gestire il software sui tuoi endpoint anche su larga scala. Guarda una demo di NinjaOne in azione oppure registrati per una prova gratuita del software.